Kurz gesagt — Vektordatenbanken sind zum unsichtbaren Rückgrat moderner künstlicher Intelligenz geworden. Im Jahr 2025 verändern diese spezialisierten Speichersysteme die Art und Weise, wie intelligente Assistenten auf ihr Gedächtnis zugreifen und den Kontext von Anfragen verstehen. Statt einfacher Stichwortsuchen ermöglichen sie eine semantische Suche, die den tieferen Sinn der Daten erfassen kann. Diese Entwicklung bereitet den Weg für autonome Agenten mit einem echten, dauerhaften Gedächtnis, die lernen und sich weiterentwickeln können, ohne ständig neu trainiert werden zu müssen. Der weltweite Markt soll 2025 einen Wert von 3,2 Milliarden US-Dollar erreichen, was die strategische Bedeutung dieser Technologie für Organisationen bestätigt, die wirklich kontextbezogene KI einsetzen möchten.
🧠 Warum Vektordatenbanken das Gedächtnis intelligenter Assistenten verändern
Inhalt
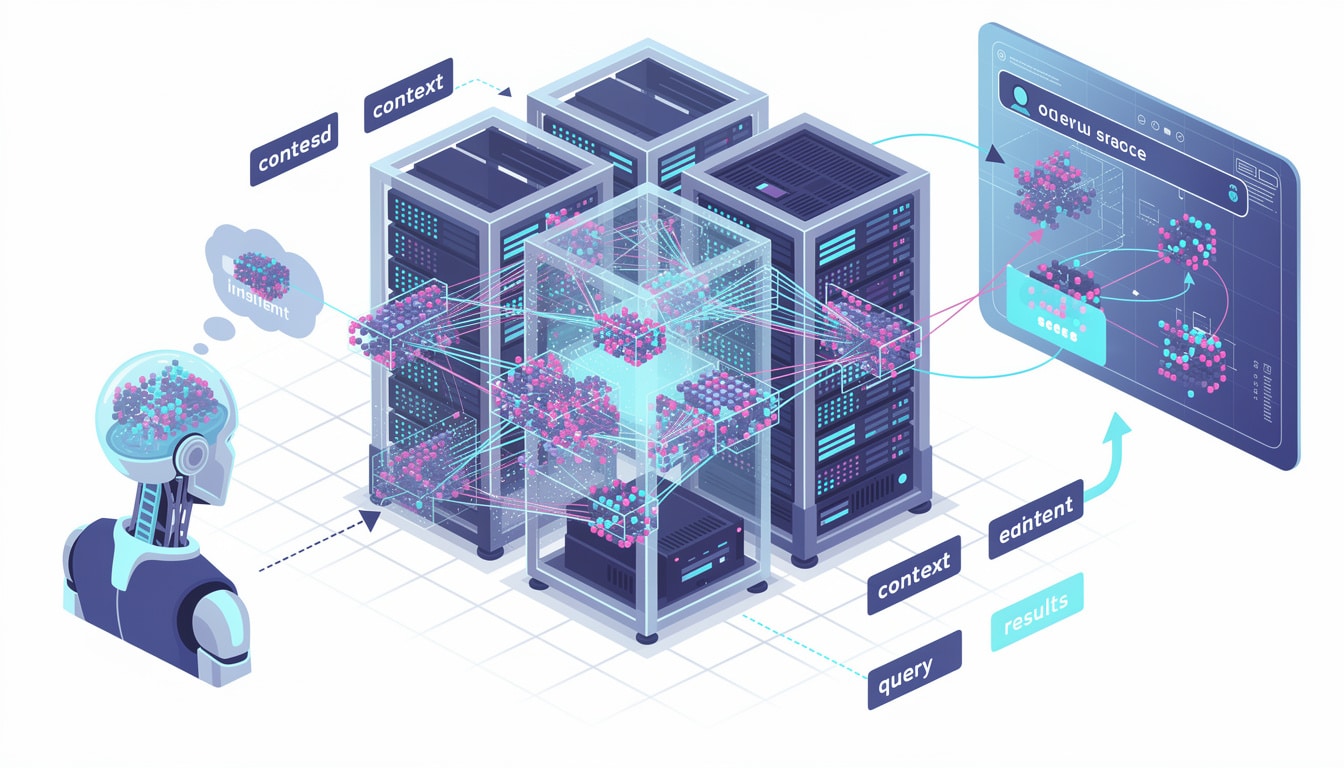
Stellen Sie sich einen KI-Assistenten vor, der sich nicht nur an Ihre genauen Worte erinnert, sondern auch den tieferen Sinn hinter Ihrer Frage versteht. Genau das ermöglichen Vektordatenbanken. Im Gegensatz zu traditionellen Systemen, die einzelne Begriffe indexieren, speichern und durchsuchen sie komplexe semantische Repräsentationen – mathematische Vektoren, die die eigentliche Essenz des Inhalts erfassen.
Dieser Ansatz revolutioniert die Funktionsweise intelligenter Assistenten. Wenn ein Nutzer eine Frage stellt, wird diese in einen numerischen Vektor umgewandelt und anschließend mit Millionen anderer in der Datenbank gespeicherter Vektoren verglichen. Die Kosinus-Ähnlichkeit, ein mathematisches Maß für Nähe, identifiziert sofort die relevantesten Informationen – selbst wenn diese andere Wörter verwenden. 🎯
Dieser Mechanismus hebt Assistenten über reine Textgeneratoren hinaus. Sie werden zu Systemen mit einem dauerhaften externen Gedächtnis, das Archive, Dokumentationen oder ganze Textkorpora durchsuchen kann, ohne jemals etwas zu vergessen. Das ist die Grundlage von RAG (Retrieval-Augmented Generation), einem Ansatz, der die sprachliche Leistungsfähigkeit von LLMs mit dem Zugriff auf aktuelles, spezialisiertes Wissen verbindet.
💾 Von der einfachen Suche zum kontextuellen Verständnis
Eine klassische Suchmaschine funktioniert über den Abgleich von Begriffen. Wenn Sie nach „wie man die GPU-Leistung optimiert“ suchen, zeigt Ihnen ein traditionelles System Dokumente, die genau diese Wörter enthalten. Eine Vektordatenbank versteht jedoch, dass „die Grafikverarbeitung beschleunigen“ und „die Geschwindigkeit des visuellen Prozessors verbessern“ dasselbe Thema behandeln. 📊
Diese Fähigkeit, semantische Nuancen zu erfassen, verändert die Nutzererfahrung grundlegend. Intelligente Assistenten, die von diesen Datenbanken gespeist werden, antworten präziser und kontextbezogener. Sie erfassen Beziehungen zwischen Konzepten, unterscheiden Synonyme und erkennen sogar ironische oder metaphorische Feinheiten, die ältere Systeme völlig übersahen.
Für Organisationen bedeutet das Dokumentations-Copiloten, die komplexe fachliche Anfragen interpretieren können, Kundensupport-Systeme, die die tatsächliche Absicht des Anfragenden verstehen, und Analyse-Assistenten, die Informationen verknüpfen können, die über Tausende von Dokumenten verstreut sind. Die vektorielle Indexierung wird so zu einem bedeutenden Wettbewerbsvorteil. 🚀
🔍 Wie Vektordatenbanken funktionieren: vom Text zum semantischen Gedächtnis
Die Funktionsweise einer Vektordatenbank beruht auf einer präzisen technologischen Kette, bei der jeder Schritt Rohdaten in von der KI nutzbare Repräsentationen umwandelt. Dieses Verfahren zu verstehen, verdeutlicht, warum diese Systeme für moderne Assistenten unverzichtbar geworden sind.
🔄 Der entscheidende Schritt: Daten in Embeddings umwandeln
Alles beginnt mit der semantischen Repräsentation der Daten. Ein Embedding-Modell wie text-embedding-ada-002 oder nomic-embed-text analysiert Ihren Text, Ihr Bild oder Ihre Audiodatei und wandelt sie in numerische Vektoren um. Diese Vektoren sind nicht zufällig – sie verkörpern Bedeutung, Kontext, Tonfall und semantische Beziehungen. 📝
Betrachten Sie dieses Beispiel: Das Wort „Bank“ erzeugt je nach Kontext einen anderen Vektor. Im Finanzwesen positioniert es sich nahe bei „Kredit“, „Darlehen“ und „Zinsen“. In der Geografie rückt es näher an „Fluss“, „Wasserlauf“ und „Ufer“. Das Embedding-Modell erfasst diese Variationen anhand Tausender mathematischer Dimensionen, die für das menschliche Auge unsichtbar sind.
Dieser Prozess gilt ebenso für Bilder. Ein Hundefoto erzeugt einen eigenen Vektor, der Ähnlichkeiten mit anderen Hundebildern aufweist, sich aber klar von Katzenbildern unterscheidet. Multimodale Modelle erweitern diese Logik, indem sie zwischen Text und Bild kompatible Vektoren erzeugen und so den Weg für eine wirklich integrierte Suche öffnen.
⚡ Indexierung und Optimierung für ultraschnelle Suchen
Millionen von Vektoren zu speichern ist eine Sache; sie augenblicklich wiederzufinden eine andere. Hier kommen ausgeklügelte Indexstrukturen ins Spiel. Algorithmen wie HNSW (Hierarchical Navigable Small World) und die Produktquantisierung schaffen Architekturen, die es ermöglichen, die nächstgelegenen Vektoren in wenigen Millisekunden zu finden – selbst in Datenbanken mit mehreren Milliarden Einträgen. 🚄
Diese Optimierungen sind für Echtzeit-Assistenten unerlässlich. Wenn ein Nutzer eine Frage stellt, kann das System nicht jeden Vektor der Datenbank analysieren – das wäre zu langsam. Die Indexierung schafft mathematische „Abkürzungen“, schnelle Wege, die es ermöglichen, relevante Dokumente zu identifizieren, ohne eine erschöpfende Durchsuchung vornehmen zu müssen.
Tools wie Pinecone, Qdrant und Chroma setzen diese Optimierungen im produktiven Einsatz um. Qdrant beispielsweise nutzt einen auf Rust basierenden Ansatz mit extrem niedriger Latenz, während Pinecone automatisch skalierbare Cloud-Architekturen verwaltet.
🎯 Semantische Suche in Aktion: jenseits von Stichwörtern
Wenn eine Frage gestellt wird, durchläuft sie denselben Prozess: die Umwandlung in einen Vektor mittels eines Embedding-Modells. Die Datenbank berechnet dann den Abstand zwischen diesem Vektor und allen anderen gespeicherten. Die Dokumente oder Passagen mit der höchsten vektoriellen Nähe steigen an die Oberfläche, ohne von exakten lexikalischen Übereinstimmungen abhängig zu sein.
Stellen Sie sich vor, ein Assistent soll die Frage „Welche sind die besten Ansätze, um den Energieverbrauch von Rechenzentren zu senken?“ beantworten. Seine Suche findet nicht nur Dokumente, die diese Begriffe explizit erwähnen, sondern auch Artikel über thermische Effizienz, Flüssigkeitskühlung oder Hardware-Optimierung – alle semantisch verwandt.
Diese auf Bedeutung basierende Fähigkeit zur Informationsgewinnung verändert die Qualität der von LLMs generierten Antworten grundlegend. Die Modelle sind nicht mehr auf ihr ursprüngliches Training beschränkt: Sie greifen dynamisch auf ein reichhaltiges, aktuelles und relevantes externes Gedächtnis zu.
🏗️ Das Open-Source-Ökosystem: den Zugang zu Vektordatenbanken demokratisieren
Innovation in der künstlichen Intelligenz beschleunigt sich, wenn Werkzeuge zugänglich werden. Im Jahr 2025 hat das Open-Source-Ökosystem Vektordatenbanken von einer teuren proprietären Technologie in eine demokratisierte Infrastruktur verwandelt. Projekte wie FAISS, Chroma, Qdrant und Milvus ermöglichen es Entwicklern, Forschern und KMUs, hochentwickelte Vektorsuchsysteme einzusetzen, ohne von den Cloud-Giganten abhängig zu sein. 💡
📚 FAISS: Metas rohe Rechenkraft im Dienst aller
FAISS (Facebook AI Similarity Search), entwickelt von Meta, bleibt eine unverzichtbare Referenz für hochperformante Vektorsuche. In C++ mit Python-Anbindung geschrieben, bietet es außergewöhnliche Geschwindigkeit und bemerkenswerte Speichereffizienz, besonders auf GPUs. Teams, die mit massiven Datenmengen arbeiten – Millionen oder Milliarden von Vektoren – bevorzugen es wegen seiner aggressiven Optimierung. 🔥
Seine massive Verbreitung in Forschungsprojekten und kritischen Systemen bestätigt seine Zuverlässigkeit. FAISS glänzt besonders dann, wenn die Latenz minimal sein muss und die Rechenressourcen begrenzt sind.
🎨 Chroma: Einfachheit für Prototyping und Iteration
Am anderen Ende des Spektrums steht Chroma, eine minimalistische Python-Vektordatenbank, die auf Einfachheit und schnelle Integration ausgelegt ist. Sie wurde für den lokalen oder verteilten Betrieb entwickelt und lässt sich nahtlos mit modernen Frameworks wie LangChain, LlamaIndex und Open WebUI integrieren. Für alle, die schnell einen RAG-Assistenten oder einen Dokumentations-Copiloten ausprobieren möchten, bietet Chroma die sanfteste Lernkurve. 🚀
Seine Stärke liegt in der Zugänglichkeit: Mit wenigen Zeilen Python können Sie Ihre eigenen Dokumente indexieren und einen kontextbezogenen Assistenten aufbauen, der Ihr eigenes Wissen nutzt. Diese Einfachheit erklärt die massive Verbreitung in Bildungsprojekten und Unternehmensprototypen.
⚙️ Qdrant: die produktionsreife Balance zwischen Leistung und Flexibilität
In Rust geschrieben, stellt Qdrant die ausgereifte Weiterentwicklung der Open-Source-Vektordatenbanken dar. Es bietet eine vollständige REST- und gRPC-API, ultraschnelle Leistung und eine Architektur, die komplexe Filter und hybride Suchen (Kombination von Vektorsuche und strukturierten Kriterien) unterstützt. Für Produktionsumgebungen, die Robustheit und Skalierbarkeit erfordern, setzt sich Qdrant als strategische Wahl durch. 🎯
Organisationen nutzen Qdrant, um Echtzeit-Empfehlungssysteme, Anomalieerkennungs-Engines und unternehmensinterne Dokumentations-Assistenten zu betreiben. Sein ausgereiftes Ökosystem und seine umfangreiche Dokumentation erleichtern die groß angelegte Einführung.
🌐 Milvus: verteilte Leistungsfähigkeit für kritische Umgebungen
Milvus treibt den Anspruch noch weiter, indem es eine verteilte Architektur für massive Produktionsumgebungen bietet. Es kann mehrere Milliarden Vektoren mit hoher Verfügbarkeit verwalten, toleriert Ausfälle und skaliert horizontal. Zusammen mit Zilliz Cloud (seiner verwalteten Version) stellt es die Lösung für Organisationen dar, die die Grenzen einer einzelnen Maschine überschritten haben. 💪
Seine wachsende Verbreitung in der Finanz-, Pharma- und Technologiebranche bestätigt seine Reife und Zuverlässigkeit unter extremen Bedingungen.
🤖 Vom klassischen RAG zum Agentic RAG: das Gedächtnis im Zentrum der Autonomie
Die Entwicklung der Vektordatenbanken endet nicht bei der Suche. Sie treibt eine tiefgreifende architektonische Transformation voran: die von einfachen Assistenten zu autonomen Agenten mit einem echten kognitiven Gedächtnis. Autonome Agenten und Automatisierung stellen die aktuelle Grenze dieser Entwicklung dar.
🔗 RAG: die Grundlage — Abfrage und Generierung
Das klassische Retrieval-Augmented Generation (RAG) funktioniert in drei einfachen Schritten. Der Nutzer stellt eine Frage; diese wird vektorisiert und in der Datenbank gesucht; die relevanten Passagen fließen in den Prompt des LLM ein, das daraufhin eine kontextbezogene Antwort generiert. Das ist linear, vorhersehbar und erstaunlich wirksam für eine breite Palette von Anwendungsfällen. 📋
Stellen Sie sich ein Unternehmen mit Tausenden technischer Dokumente vor. Ohne RAG würde ein generischer Assistent dieses spezialisierte Wissen ignorieren. Mit RAG und einer Vektordatenbank wird der Assistent sofort zum Experten, findet die relevanten Abschnitte und formuliert Antworten, die in der Realität der Organisation verankert sind.
🧩 Agent RAG: Entscheidungsfindung und Planung
Agent RAG geht einen Schritt weiter. Statt nur eine einzige Suche durchzuführen, entscheidet der Agent dynamisch, wann er die Datenbank abfragt, wie er mehrere Ergebnisse kombiniert und ob eine neue Suche nötig ist. Er wird in der Lage, über seine eigenen Antworten nachzudenken, Widersprüche zu erkennen und mehrere Suchschritte zu planen. 🎲
Frameworks wie LangGraph und OpenDevin setzen diese Logik um und ermöglichen es Agenten, komplexe Pläne zu entwickeln: „Zuerst suche ich die API-Dokumentation. Dann überprüfe ich die Code-Beispiele. Schließlich gleiche ich diese Informationen mit den häufig gestellten Fragen der Nutzer ab.“ Diese Planungsfähigkeit hebt die Intelligenz vom Reaktiven zum Proaktiven.
🧠 Agentic RAG: lebendiges Gedächtnis und Selbstlernen
Agentic RAG stellt den Höhepunkt dar: einen geschlossenen Kreislauf, in dem der Agent seine Umgebung beobachtet, Schlussfolgerungen zieht, handelt und anschließend sein eigenes vektorielles Gedächtnis aktualisiert. Dieser Zyklus erzeugt eine Form adaptiver und autonomer Intelligenz. Der Agent speichert seine Entdeckungen, Fehler und Erfolge und baut so schrittweise eine erfahrungsbasierte Wissensbasis auf. 🌟
Konkret könnte ein Monitoring-Agent automatisch erkannte Artikel indexieren, Trends analysieren, Anomalien identifizieren und seine Schlussfolgerungen speichern, um künftige Analysen zu informieren. Agentic RAG verändert die Beziehung zwischen Wissen und Entscheidung: Das vektorielle Gedächtnis ist nicht mehr statisch, sondern lebendig, entwicklungsfähig und spiegelt die angesammelte Erfahrung wider.
🌍 Praxisbeispiele: wie Vektordatenbanken Unternehmensassistenten neu erfinden
Die Theorie ist überzeugend, doch erst bei der Betrachtung realer Einsätze wird das Potenzial greifbar. In verschiedenen Branchen verändern Vektordatenbanken die Art und Weise, wie Organisationen ihre intelligenten Assistenten aufbauen. Die Integrationsstrategie autonomer Agenten zeigt, wie Unternehmen diese Transformationen strukturieren.
📄 Dokumentations-Assistenten: die Vergangenheit in Sekunden abfragen
Ein Pharmaunternehmen verfügt über 50 Jahre an Archiven – Patente, klinische Studien, Compliance-Berichte, regulatorische Korrespondenz. Traditionell dauerte es Tage, ein bestimmtes Dokument zu finden. Mit einer Vektordatenbank, die einen Assistenten speist, stellt ein Forscher einfach die Frage „Welche Vorgeschichte hat dieses Molekül in unseren Archiven?“, und das System findet die relevanten Passagen unter Millionen von Seiten. 🔬
Dieses Szenario wiederholt sich in Anwaltskanzleien (Rechtsprechungssuche), Content-Agenturen (frühere Artikel wiederfinden) und Personalabteilungen (vergangene Richtlinien durchsuchen). Maschinelles Lernen ist nicht mehr nur der Vorhersage vorbehalten: Es wird zu einem Werkzeug zur Wiederentdeckung und Nutzung des vorhandenen Informationsbestands.
💬 Kontextbezogener Kundensupport: das Problem wirklich verstehen
Ein Kundensupport-Assistent, der von einer Vektordatenbank mit 100.000 vergangenen Tickets gespeist wird, versteht, dass „die App funktioniert nicht mehr auf meinem alten Handy“ und „Versionsinkompatibilität“ dasselbe Problem beschreiben. Er findet sofort erprobte Lösungen, schlägt präzise Fehlerbehebungsschritte vor und eskaliert bei Unzufriedenheit des Kunden intelligent an einen Menschen – mit dem gesamten relevanten Kontext. 🎧
Der Effekt ist messbar: kürzere durchschnittliche Lösungszeit, höhere Kundenzufriedenheit, geringere Belastung der Teams. Organisationen, die diesen Ansatz umgesetzt haben, berichten regelmäßig von einer Effizienzsteigerung von 30 bis 40 %.
🔐 Sicherheitsanalyse und Anomalieerkennung
In der Cybersicherheit indexiert eine Vektordatenbank vergangene Vorfallberichte, Malware-Signaturen und bekannte Angriffsmuster. Wenn eine neue Bedrohung auftaucht, vektorisiert das System sie und vergleicht sie mit Tausenden früheren Bedrohungen. Es erkennt Ähnlichkeiten, die bei manueller Analyse unentdeckt blieben, und warnt die Teams vor verborgenen Verbindungen. 🛡️
Das verwandelt die Anomalieerkennung von einer mühsamen Aufgabe in einen kontinuierlichen, intelligenten Prozess. Die Leistungsoptimierung wird hier entscheidend: Jede Millisekunde zählt, wenn eine aktive Bedrohung gestoppt werden muss.
🛠️ Open WebUI und Chroma: lokale und kontextbezogene KI demokratisieren
Hinter all dieser Komplexität verbirgt sich eine wichtige Realität: Die Werkzeuge, die zum Aufbau dieser Systeme benötigt werden, sind heute kostenlos, Open Source und für alle zugänglich. Open WebUI und Chroma bilden ein starkes Duo, das technische Komplexität in eine reibungslose Nutzererfahrung verwandelt. 🎯
🖥️ Open WebUI: die Oberfläche, die KI ohne Code zugänglich macht
Open WebUI ist eine minimalistische, aber leistungsstarke Weboberfläche, die eine Brücke zwischen Ihnen, Ihren Daten und lokalen KI-Modellen schafft. Sie laden Ihre Dokumente hoch – PDF, Markdown, Bilder, Textdateien – und die Oberfläche übernimmt automatisch die vektorielle Indexierung, Speicherung und Abfrage. Wenige Minuten später unterhalten Sie sich mit Ihrem eigenen kontextbezogenen Assistenten, ohne Ihre Daten jemals der Cloud auszusetzen. 🌐
Was Open WebUI revolutionär macht, ist, dass keine technischen Kenntnisse erforderlich sind. Sie müssen Embeddings, Vektoren oder Indexierungsalgorithmen nicht verstehen. Sie drücken einen Knopf, wählen Ihre Datei aus, und das System erledigt den Rest. Für lokale KI ist es das, was WordPress für das Bloggen war: eine transformative Demokratisierung.
📦 Chroma als Fundament: leichtgewichtig, anpassbar, integriert
Unter der Haube nutzt Open WebUI häufig Chroma als Vektor-Engine. Chroma übernimmt die schwere Arbeit: die Umwandlung von Dokumenten in Embeddings, optimierte Indexierung, ultraschnelle semantische Suche. Durch seine Python-first-Natur lässt es sich sofort in bestehende Pipelines integrieren. 🔧
Entwickler schätzen, dass Chroma einfach genug für einen Prototyp ist – wenige Zeilen Code – aber robust genug, um Produktionseinsätze zu tragen. Es lässt sich problemlos mit LangChain, LlamaIndex und anderen modernen KI-Frameworks integrieren.
🔄 Der vollständige Workflow: vom Dokument zur kontextbezogenen Antwort
Der Ablauf ist für den Nutzer transparent, aber technisch elegant. Ein Nutzer lädt ein 500-seitiges PDF zur DSGVO-Regulierung hoch. Open WebUI zerlegt es automatisch in Passagen, vektorisiert sie über ein Embedding-Modell (lokal, ohne externe APIs) und indexiert sie in Chroma. Wenn der Nutzer fragt „Welche Pflichten habe ich bezüglich der Einwilligung?“, findet das System die relevanten Abschnitte und speist ein lokales LLM (über Ollama oder vLLM), das eine präzise Antwort generiert. ✨
All das geschieht lokal und privat, ohne Token- oder API-Kosten. Es ist ein lebendiger Beweis dafür, wie Vektordatenbanken KI von einer zentralisierten Ressource in eine persönliche, souveräne Infrastruktur verwandeln.
🎯 Die eigene Vektordatenbank aufbauen: Prinzipien und Anwendungsfälle
Die Frage, die sich viele Fachleute stellen, ist naheliegend: Lohnt es sich wirklich, eine persönliche Vektordatenbank anzulegen? Die Antwort hängt vom jeweiligen Kontext ab, doch für Autoren, Forscher, Journalisten und Entwickler sind die Vorteile oft transformativ. 💡
🏆 Warum eine persönliche Vektordatenbank sinnvoll ist
Stellen Sie sich vor, Sie sind seit zehn Jahren technischer Redakteur. Sie haben Hunderte von Artikeln geschrieben, jeder mit Erklärungen, Vergleichen und Schlussfolgerungen. Ohne Vektordatenbank bleibt dieses Wissen in Ihren Archiven verstreut und lässt sich beim Schreiben eines neuen Artikels schwer abrufen. Mit einer persönlichen Vektordatenbank, die alle Ihre bisherigen Inhalte indexiert, bauen Sie schrittweise ein eigenes semantisches Gedächtnis auf.
Beim Schreiben können Sie dieses Gedächtnis befragen: „Wie lautete mein Fazit zur Leistung von Rust im Jahr 2023?“ oder „Welche Beispiele habe ich zur Erklärung der Multithread-Synchronisation verwendet?“ Das System findet Ihre früheren Artikel wieder, stärkt die redaktionelle Kohärenz und beschleunigt Ihren kreativen Prozess. 📚
Für Forscher wird eine Vektordatenbank, die Ihre Papers, Notizen und Forschungsdaten indexiert, zu einem unschätzbaren persönlichen Assistenten. Für Entwickler entsteht durch die Indexierung des Codebase und seiner Dokumentation eine semantische Suchmaschine, die mit einfachen grep-Befehlen nicht vergleichbar ist.
⚖️ Die pragmatischen Grenzen, die man kennen sollte
Allerdings macht es keinen Sinn, für alles eine Vektordatenbank anzulegen. Jedes vektorisierte Dokument verbraucht Speicherplatz, (anfängliche) Rechenleistung und möglicherweise Arbeitsspeicher. Eine mit irrelevanten Inhalten überladene Datenbank erzeugt Rauschen: Die Suche liefert zu viele unpassende Ergebnisse, was die Relevanz verwässert. 🚫
Ein effizienterer Ansatz ist eine strategisch segmentierte Struktur. Sie könnten mehrere thematische Datenbanken anlegen: eine für Ihre Artikel und Veröffentlichungen, eine für technische Dokumentation, eine für Ihre Forschungsnotizen. Diese Modularität erleichtert die Wartung und verbessert die Genauigkeit der Ergebnisse.
🚀 Empfohlenes Setup: minimalistisch und erweiterbar
Für den Einstieg reicht eine einfache Architektur: Chroma als Vektordatenbank, Ollama oder vLLM zum lokalen Ausführen eines LLM, LangChain oder LlamaIndex zur Orchestrierung der Pipeline. Wenn Sie eine visuelle Oberfläche ohne Code wünschen, fügen Sie Open WebUI darüber hinzu. Dieser Stack ist kostenlos, Open Source und in wenigen Minuten auf jedem modernen Computer einsatzbereit. 💻
Mit wachsenden Anforderungen – mehr Dokumente, geringere erforderliche Latenz, verteilter Einsatz – können Sie zu Qdrant oder Milvus migrieren, ohne größere Änderungen am Anwendungscode vornehmen zu müssen. Moderne Frameworks abstrahieren diese Infrastrukturdetails und ermöglichen eine schrittweise Weiterentwicklung.
📈 Die geschäftliche Wirkung: jenseits der Technologie
Vektordatenbanken allein auf Technologie zu reduzieren wäre oberflächlich. Ihre wahre Stärke liegt in der Transformation geschäftlicher Fähigkeiten. Ein vollständiger Leitfaden zu RAG-Projekten in Unternehmen untersucht, wie diese Systeme echten operativen Mehrwert schaffen.
⏱️ Messbare Effizienzgewinne
Teams, die von Vektordatenbanken gespeiste Assistenten nutzen, berichten von einer konkreten Produktivitätssteigerung. Forscher finden Informationen in Minuten statt Stunden. Support-Teams lösen Tickets schneller. Analysten erkennen verborgene Muster in Datensätzen, die für manuelle Analysen zu umfangreich wären. Diese Gewinne sind nicht theoretisch – sie übersetzen sich in eingesparte Zeit und verbesserte Qualität. 💰
🎓 Kapitalisierung impliziten Wissens
Organisationen besitzen ein institutionelles Gedächtnis, das in Köpfen, E-Mails und schlecht abgelegten Dokumenten verstreut ist. Eine gut strukturierte Vektordatenbank erfasst dieses Wissen, macht es zugänglich und schützt es vor dem Weggang von Mitarbeitern. Es handelt sich um kapitalisiertes Wissen, das noch lange nach seinem ursprünglichen Kontext nutzbar bleibt.
🔮 Beschleunigte Innovation
Der einfache Zugang zu einer reichhaltigen Wissensbasis fördert Experimentierfreude und intelligente Wiederverwendung. Teams entdecken Verbindungen zwischen Bereichen, wenden frühere Lösungen auf neue Probleme an und kombinieren Ideen auf unerwartete Weise. Das ist ein Motor für inkrementelle, aber nachhaltige Innovation. 🌟
🔐 Datenschutz und Datensouveränität: warum lokal zählt
In einer Zeit, in der Datenschutzbedenken allgegenwärtig sind, ist die Tatsache, dass Open-Source-Vektordatenbanken lokal laufen können, ein bedeutender strategischer Vorteil. Ihre Dokumente, Embeddings und Anfragen bleiben auf Ihrer eigenen Infrastruktur, unzugänglich für Cloud-Anbieter. 🔒
Für Organisationen, die mit sensiblen Daten arbeiten – Finanzwesen, Pharmaindustrie, Verteidigung, Kundendaten – ist diese Souveränität kein Luxus, sondern eine rechtliche und ethische Notwendigkeit. DSGVO, HIPAA, lokale Compliance-Vorschriften: Lokale KI bietet einen natürlichen Rahmen für die Einhaltung von Vorschriften, ohne Vertragsverhandlungen oder komplexe Zertifizierungen.
Selbst für weniger stark regulierte Organisationen bietet die vollständige Kontrolle über die eigene KI-Infrastruktur Sicherheit und Unabhängigkeit von Preisänderungen oder Richtlinienwechseln der Cloud-Anbieter. Das ist ein starkes Argument für selbst gehostete Open-Source-Vektordatenbanken.
🌐 Integration mit modernen Frameworks: LangChain, LlamaIndex und darüber hinaus
Das KI-Ökosystem existiert nicht isoliert. Vektordatenbanken glänzen, wenn sie sich harmonisch mit anderen Komponenten verbinden. Der Vergleich zwischen CrewAI und LangChain zeigt, wie diese Frameworks moderne KI-Architekturen strukturieren.
🔗 LangChain: transparente Orchestrierung
LangChain abstrahiert die Komplexität der Integration von LLM und Vektordatenbank hinter einer eleganten Python-Schnittstelle. Ein Entwickler kann in wenigen Dutzend Zeilen eine vollständige RAG-Pipeline aufbauen und dabei das LLM, die Vektordatenbank, die Retriever und die Prompting-Strategie deklarieren. LangChain übernimmt die Details und lässt den Entwickler sich auf die Geschäftslogik konzentrieren. 🛠️
📊 LlamaIndex: die intelligente Strukturierung von Dokumenten
LlamaIndex (ehemals GPT Index) geht noch weiter, indem es Dokumente vor der Vektorisierung intelligent strukturiert. Es erstellt hierarchische Indizes, analysiert die Dokumentstruktur und extrahiert relevante Metadaten. Dieser Ansatz führt zu relevanteren Suchergebnissen und differenzierteren Zusammenfassungen. 📋
🤖 CrewAI: die Multi-Agenten-Orchestrierung
Das neuere CrewAI erforscht die Orchestrierung mehrerer autonomer Agenten, die zusammenarbeiten. Jeder verfügt über eigenen Zugriff auf spezialisierte Vektordatenbanken, Werkzeuge und definierte Rollen. Dieser Multi-Agenten-Ansatz erhöht die Zuverlässigkeit, Transparenz und die Fähigkeit, komplexe Probleme durch Zerlegung zu bewältigen. 🎭
Diese Frameworks stehen nicht in Konkurrenz zueinander: Sie adressieren unterschiedliche Abstraktionsebenen. LangChain eignet sich für schnelles Prototyping und einfache Fälle. LlamaIndex glänzt bei anspruchsvoller Indexierung. CrewAI ist optimal für komplexe Multi-Agenten-Systeme. Die Wahl hängt von Ihrer Problemstellung und Ihrer architektonischen Präferenz ab.
📊 Metriken und Monitoring: die Qualität des Systems sicherstellen
Wie jedes produktive System erfordern auch Vektordatenbanken kontinuierliches Monitoring und Optimierung. Es reicht nicht, Dokumente einfach zu indexieren; man muss sicherstellen, dass die Qualität der Suchergebnisse im Laufe der Zeit hoch bleibt. 📈
🎯 Die Relevanz der Suche messen
Die klassischen Suchmetriken gelten auch hier: Precision (welcher Anteil der zurückgegebenen Ergebnisse relevant ist), Recall (welcher Anteil der relevanten Dokumente gefunden wurde) und der F1-Score (das Zusammenspiel beider). Für RAG-Anwendungsfälle sind zusätzliche Metriken wichtig: die Qualität der Generierung (sind die generierten Antworten sachlich korrekt?) und die Latenz (beeinflusst die Antwortzeit die Nutzererfahrung?). ⏱️
🔍 Monitoring von Embeddings und Drift
Mit wachsender Datenbank können sich die von den Modellen erzeugten Embeddings subtil verändern, besonders wenn Sie Ihr Embedding-Modell aktualisieren. Diese „Drift“ kann die Relevanz der Suche allmählich verschlechtern. Die Qualität der Embeddings zu überwachen – ihren Mittelwert, ihre Varianz, ihre Konsistenz – hilft, diese Probleme zu erkennen, bevor sie die Nutzer ernsthaft beeinträchtigen. 📉
💡 Nutzer-Feedback als Optimierungssignal
Der beste Hinweis auf ein Problem ist oft das Nutzer-Feedback: „Die Ergebnisse sind nicht relevant“, „Dieser Artikel sollte hier nicht auftauchen“, „Warum scheitert der Assistent immer wieder an dieser Frage?“ Diese Signale identifizieren Grenzfälle und leiten Optimierungen. Ihr System so zu instrumentieren, dass es dieses Feedback erfasst, schafft eine Schleife kontinuierlicher Verbesserung. 🔄
🚀 Zukunftsperspektiven: auf dem Weg zu einer wirklich autonomen und lernenden KI
Im Jahr 2026 steht die Nutzung von Vektordatenbanken erst am Anfang. Die aufkommenden Trends weisen auf eine neue Ära hin, in der diese Systeme nicht mehr bloße Speicher sind, sondern lebendige kognitive Einheiten, fähig zu kontinuierlichem Lernen und wachsender Autonomie. 🌟
🧬 Langzeitgedächtnis und kontinuierliches Lernen
Die KI-Agenten von morgen werden bei jedem Gespräch nicht mehr eine Tabula rasa sein. Sie werden über dauerhafte, in Vektordatenbanken gespeicherte Erinnerungen verfügen, die es ermöglichen, Lernerfahrungen, gemachte Fehler und den Nutzerkontext zu behalten. Diese Kontinuität verändert die Beziehung zwischen Nutzer und KI grundlegend: von flüchtig und zustandslos zu dauerhaft und langfristig kontextbezogen. 📚
⚙️ Fortgeschrittene hybride und multimodale Suche
Die nächsten Generationen von Vektordatenbanken werden nativ Suchen unterstützen, die Text, Bilder, Audio und sogar Video in einem einheitlichen semantischen Raum kombinieren. Ein Nutzer könnte „zeig mir die Momente im Meeting, in denen dieses Thema besprochen wurde“ suchen, indem er Video-, Text- und Audioarchive gleichzeitig abfragt. 🎬
🌍 Dezentralisierung und Föderation
Mit wachsenden Souveränitätsbedenken werden föderierte Architekturen von Vektordatenbanken entstehen, bei denen mehrere Instanzen kommunizieren, während sie souverän bleiben. Eine Organisation könnte Partnern selektiv Fragmente ihrer Datenbank zugänglich machen, ohne den gesamten Inhalt offenzulegen. 🔐
Diese Entwicklungen verwandeln Vektordatenbanken von bloßen technischen Zusatzwerkzeugen in eine fundamentale Säule einer neuen Generation von KI: anpassungsfähig, autonom, datenschutzfreundlich und im kognitiven Sinne wirklich intelligent. 🎯
Author Profile
Latest entries
 Ratgeber20 November 2026Verbraucherkredit: Mini-Kredite, Ratenzahlung und Dispo besser reguliert
 Planet15 November 2026CO2-Emissionen: Warum der Verkehr der Schwachpunkt des Klimaschutzes in Frankreich bleibt
 Künstliche Intelligenz12 November 2026Imagine Enterprise: IBM und Microsoft vereinen ihre KI-Agenten für Großunternehmen
 Wirtschaft11 November 2026Zinssatz des Livret A: Berechnung und Grenzen verstehen
Dieser Artikel wurde mit Unterstützung künstlicher Intelligenz erstellt. Redaktionsrichtlinie