En bref — Les bases de données vectorielles sont devenues l’épine dorsale invisible de l’intelligence artificielle moderne. En 2025, ces systèmes de stockage spécialisés transforment la manière dont les assistants intelligents accèdent à la mémoire et comprennent le contexte des requêtes. Plutôt que de simples recherches par mots-clés, elles permettent une recherche sémantique capable de saisir le sens profond des données. Cette évolution ouvre la voie à des agents autonomes dotés d’une véritable mémoire persistante, capables d’apprendre et d’évoluer sans réentraînement constant. Le marché mondial atteindrait 3,2 milliards de dollars en 2025, confirmant l’importance stratégique de cette technologie pour les organisations cherchant à déployer des IA réellement contextuelles.
🧠 Pourquoi les bases de données vectorielles transforment la mémoire des assistants intelligents
Sommaire de l'article
Imaginez un assistant IA capable de se souvenir non seulement de vos mots exacts, mais de comprendre le sens profond derrière votre question. C’est exactement ce que permettent les bases de données vectorielles. Contrairement aux systèmes traditionnels qui indexent des termes individuels, elles stockent et interrogent des représentations sémantiques complexes — des vecteurs mathématiques qui capturent l’essence même du contenu.
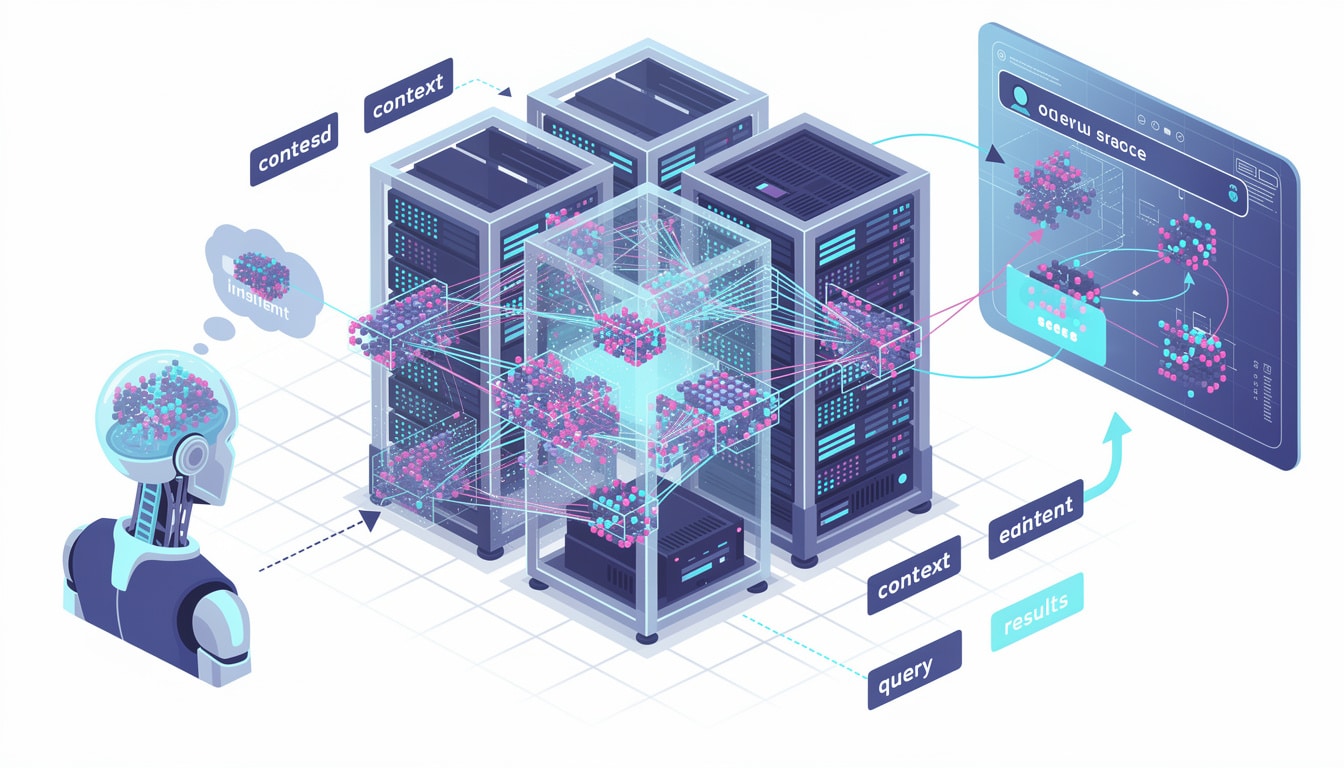
Cette approche révolutionne la manière dont les assistants intelligents fonctionnent. Lorsqu’un utilisateur pose une question, celle-ci est transformée en vecteur numérique, puis comparée aux millions d’autres vecteurs stockés dans la base. La similarité cosinus, une mesure mathématique de proximité, identifie instantanément les informations les plus pertinentes, même si elles utilisent des mots différents. 🎯
Ce mécanisme élève les assistants au-delà de simples générateurs de texte. Ils deviennent des systèmes dotés d’une mémoire externe persistante, capable de consulter des archives, des documentations ou des corpus entiers sans jamais oublier. C’est la base du RAG (Retrieval-Augmented Generation), une approche qui combine la puissance linguistique des LLM avec l’accès à une connaissance actualisée et spécialisée.
💾 De la simple recherche à la compréhension contextuelle
Un moteur de recherche classique fonctionne sur des correspondances de termes. Si vous cherchez « comment optimiser les performances GPU », un système traditionnel vous proposera des documents contenant exactement ces mots. Mais une base vectorielle comprend que « accélérer le traitement graphique » et « améliorer la vitesse du processeur visuel » parlent du même sujet. 📊
Cette capacité à saisir les nuances sémantiques transforme l’expérience utilisateur. Les assistants intelligents alimentés par ces bases répondent avec davantage de précision et de contexte. Ils capturent les relations entre concepts, distinguent les synonymes, et même détectent les subtilités ironiques ou métaphoriques que les systèmes plus anciens ignoraient complètement.
Pour les organisations, cela signifie des copilotes documentaires capables d’interpréter les requêtes métier complexes, des systèmes de support client qui comprennent l’intention réelle du demandeur, et des assistants d’analyse capables de lier des informations dispersées dans des milliers de documents. L’indexation vectorielle devient ainsi un avantage compétitif majeur. 🚀
🔍 Comment fonctionnent les bases de données vectorielles : du texte à la mémoire sémantique
Le fonctionnement d’une base vectorielle repose sur une chaîne technologique précise, où chaque étape transforme les données brutes en représentations exploitables par l’IA. Comprendre ce processus éclaire pourquoi ces systèmes sont devenus incontournables pour les assistants modernes.
🔄 L’étape critique : transformer les données en embeddings
Tout commence par la représentation sémantique des données. Un modèle d'embedding, comme text-embedding-ada-002 ou nomic-embed-text, analyse votre texte, votre image ou votre audio, et les convertit en vecteurs numériques. Ces vecteurs ne sont pas aléatoires — ils encapsulent le sens, le contexte, la tonalité, et les relations sémantiques. 📝
Considérez cet exemple : le mot « banque » produit un vecteur différent selon le contexte. En finance, il se positionne près de « crédit », « prêt » et « intérêt ». En géographie, il se rapproche de « fleuve », « cours d’eau » et « rive ». Le modèle d'embedding capture ces variations grâce à des milliers de dimensions mathématiques invisibles à l’œil humain.
Ce processus s’applique également aux images. Une photo de chien génère un vecteur unique qui partage des similitudes avec d’autres images de chiens, mais se distingue clairement des images de chats. Les modèles multimodaux étendent cette logique en créant des vecteurs compatibles entre texte et image, ouvrant la voie à une recherche vraiment intégrée.
⚡ Indexation et optimisation pour les recherches ultra-rapides
Stocker des millions de vecteurs est une chose ; les retrouver instantanément en est une autre. C’est là qu’interviennent les structures d’index sophistiquées. Des algorithmes comme HNSW (Hierarchical Navigable Small World) et la quantification de produit créent des architectures permettant de chercher les vecteurs les plus proches en quelques millisecondes seulement, même dans des bases contenant plusieurs milliards d’entrées. 🚄
Ces optimisations sont essentielles pour les assistants en temps réel. Lorsqu’un utilisateur pose une question, le système ne peut pas analyser chaque vecteur de la base : ce serait trop lent. L’indexation crée des « raccourcis » mathématiques, des voies rapides permettant d’identifier les documents pertinents sans fouiller exhaustivement.
Des outils comme Pinecone, Qdrant et Chroma implémentent ces optimisations en production. Qdrant, par exemple, utilise une approche basée sur Rust offrant une latence extrêmement faible, tandis que Pinecone gère des architectures cloud scalables automatiquement.
🎯 La recherche sémantique en action : au-delà des mots-clés
Lorsqu’une question est posée, elle subit le même processus : transformation en vecteur via un modèle d'embedding. La base calcule alors la distance entre ce vecteur et tous les autres stockés. Les documents ou passages avec la proximité vectorielle la plus élevée remontent en surface, sans dépendre de correspondances lexicales exactes.
Imaginez qu’un assistant doive répondre à « Quelles sont les meilleures approches pour réduire la consommation énergétique des datacenters ? » Sa recherche retrouvera non seulement des documents mentionnant explicitement ces termes, mais aussi des articles discutant d’efficacité thermique, de refroidissement par liquide, ou d’optimisation matérielle — tous sémantiquement alignés.
Cette capacité de récupération d’information basée sur le sens transforme radicalement la qualité des réponses générées par les LLM. Les modèles ne se limitent plus à leur entraînement originel : ils accèdent dynamiquement à une mémoire externe riche, actuelle et pertinente.
🏗️ L’écosystème open source : démocratiser l’accès aux bases vectorielles
L’innovation en intelligence artificielle s’accélère quand les outils deviennent accessibles. En 2025, l’écosystème open source a transformé les bases vectorielles d’une technologie propriétaire coûteuse en infrastructure démocratisée. Des projets comme FAISS, Chroma, Qdrant et Milvus permettent aux développeurs, chercheurs et PME de déployer des systèmes de recherche vectorielle sophistiqués sans dépendre des géants du cloud. 💡
📚 FAISS : la puissance brute de Meta au service de tous
FAISS (Facebook AI Similarity Search), développée par Meta, reste une référence incontournable pour la recherche vectorielle haute performance. Écrite en C++ avec des liaisons Python, elle offre une rapidité exceptionnelle et une efficacité mémoire remarquable, particulièrement sur GPU. Les équipes travaillant sur des volumes massifs — millions ou milliards de vecteurs — la privilégient pour son optimisation agressive. 🔥
Son adoption massive dans les projets de recherche et les systèmes critiques confirme sa fiabilité. FAISS brille particulièrement quand la latence doit être minimale et que les ressources computationnelles sont contraintes.
🎨 Chroma : la simplicité pour prototyper et itérer
À l’opposé du spectre se trouve Chroma, une base vectorielle Python minimaliste pensée pour la simplicité et l’intégration rapide. Conçue pour fonctionner localement ou de manière distribuée, elle s’intègre naturellement avec les frameworks modernes comme LangChain, LlamaIndex et Open WebUI. Pour quiconque souhaite expérimenter rapidement un assistant RAG ou un copilote documentaire, Chroma offre la courbe d’apprentissage la plus douce. 🚀
Son point fort réside dans l’accessibilité : en quelques lignes de Python, vous pouvez indexer vos propres documents et construire un assistant contextualisé capable d’exploiter votre savoir maison. Cette simplicité explique son adoption massive dans les projets éducatifs et les prototypes d’entreprise.
⚙️ Qdrant : l’équilibre production entre performance et flexibilité
Écrite en Rust, Qdrant représente l’évolution mature des bases vectorielles open source. Elle offre une API REST et gRPC complète, des performances ultrarapides et une architecture capable de supporter des filtres complexes et des recherches hybrides (combinant recherche vectorielle et critères structurés). Pour les déploiements production exigeant robustesse et scalabilité, Qdrant s’impose comme choix stratégique. 🎯
Les organisations utilisent Qdrant pour alimenter des systèmes de recommandation temps réel, des moteurs de détection d’anomalies et des assistants documentaires en entreprise. Son écosystème mature et sa documentation riche en facilitent l’adoption à grande échelle.
🌐 Milvus : la puissance distribuée pour les environnements critiques
Milvus pousse l’ambition plus loin en proposant une architecture distribuée conçue pour les environnements production massifs. Capable de gérer plusieurs milliards de vecteurs avec haute disponibilité, elle tolère les pannes et évolue horizontalement. Associée à Zilliz Cloud (sa version managée), elle représente la solution pour les organisations ayant dépassé les limites d’une seule machine. 💪
Son adoption croissante dans les secteurs financiers, pharmaceutiques et technologiques confirme sa maturité et sa fiabilité en conditions extrêmes.
🤖 Du RAG classique à l’Agentic RAG : la mémoire au cœur de l’autonomie
L’évolution des bases vectorielles ne s’arrête pas à la recherche. Elle propulse une transformation architecturale profonde : celle des assistants simples vers les agents autonomes dotés d’une véritable mémoire cognitive. Les agents autonomes et l’automatisation représentent la frontière actuelle de cette évolution.
🔗 RAG : le fondement — consultation et génération
Le Retrieval-Augmented Generation (RAG) classique fonctionne en trois étapes simples. L’utilisateur pose une question ; elle est vectorisée et recherchée dans la base ; les passages pertinents alimentent le prompt du LLM, qui génère une réponse contextuelle. C’est linéaire, prévisible, et étonnamment efficace pour une vaste gamme de cas d’usage. 📋
Imaginez une entreprise ayant des milliers de documents techniques. Sans RAG, un assistant générique ignorerait cette connaissance spécialisée. Avec RAG et une base vectorielle, l’assistant devient instantanément expert, retrouvant les sections pertinentes et construisant des réponses ancrées dans la réalité de l’organisation.
🧩 Agent RAG : la prise de décision et la planification
L’Agent RAG franchit un pas. Plutôt que d’effectuer une seule recherche, l’agent décide dynamiquement quand interroger la base, comment combiner plusieurs résultats, et si une nouvelle recherche est nécessaire. Il devient capable de raisonner sur ses propres réponses, de détecter des contradictions et de planifier plusieurs étapes de recherche. 🎲
Des frameworks comme LangGraph et OpenDevin implémentent cette logique, permettant aux agents de construire des plans complexes : « D’abord, je vais chercher la documentation de l’API. Ensuite, je vais vérifier les exemples de code. Enfin, je vais confronter ces informations avec les questions fréquentes des utilisateurs. » Cette capacité de planification élève l’intelligence au-delà du réactif vers le proactif.
🧠 Agentic RAG : la mémoire vivante et l’auto-apprentissage
L’Agentic RAG représente l’apogée : une boucle fermée où l’agent observe son environnement, raisonne, agit, puis met à jour sa propre mémoire vectorielle. Ce cycle crée une forme d’intelligence adaptative et autonome. L’agent enregistre ses découvertes, ses erreurs, ses succès, construisant progressivement une base de connaissances expérientielle. 🌟
Concrètement, un agent de veille pourrait indexer automatiquement les articles détectés, analyser les tendances, identifier les anomalies et mémoriser ses conclusions pour éclairer ses analyses futures. L’Agentic RAG transforme la relation entre connaissance et décision : la mémoire vectorielle n’est plus statique mais vivante, évolutive, reflet de l’expérience accumulée.
🌍 Cas d’usage réels : comment les bases vectorielles réinventent les assistants en entreprise
La théorie est convaincante, mais c’est en observant les déploiements réels que le potentiel devient tangible. À travers différents secteurs, les bases vectorielles transforment la manière dont les organisations construisent leurs assistants intelligents. La stratégie d’intégration des agents autonomes montre comment les entreprises structurent ces transformations.
📄 Assistants documentaires : interroger le passé en quelques secondes
Une entreprise pharmaceutique dispose de 50 ans d’archives — brevets, études cliniques, rapports de conformité, correspondances réglementaires. Traditionnellement, retrouver un document spécifique prenait des jours. Avec une base vectorielle alimentant un assistant, un chercheur pose simplement « Quels sont les antécédents de cette molécule dans nos archives ? », et le système retrouve les passages pertinents parmi des millions de pages. 🔬
Ce scénario se reproduit dans les cabinets juridiques (recherche de jurisprudence), les agences de contenu (retrouver des articles antérieurs), et les services RH (explorer les politiques passées). L’apprentissage automatique n’est plus réservé à la prédiction : il devient un outil de redécouverte et d’exploitation du patrimoine informatif existant.
💬 Support client contextualisé : comprendre vraiment le problème
Un assistant de support client alimenté par une base vectorielle de 100 000 tickets passés comprend que « l’app ne marche plus sur mon vieux téléphone » et « incompatibilité de version » décrivent le même problème. Il retrouve instantanément les solutions éprouvées, propose des étapes de dépannage précises et, si le client ne satisfait pas, escalade intelligemment vers un humain avec tout le contexte pertinent. 🎧
L’effet est mesurable : réduction du temps moyen de résolution, satisfaction client accrue, diminution de la charge sur les équipes. Les organisations qui ont implémenté cette approche rapportent régulièrement 30-40% d’amélioration en efficacité.
🔐 Analyse de sécurité et détection d’anomalies
Dans la cybersécurité, une base vectorielle indexe les rapports d’incident passés, les signatures de malwares et les patterns d’attaques connues. Lorsqu’une nouvelle menace émerge, le système la vectorise et la compare aux milliers de menaces antérieures. Il identifie des similarités inaperçues à l’analyse manuelle, alertant les équipes sur des connexions cachées. 🛡️
Cela transforme la détection d’anomalies d’une tâche laborieuse en processus continu et intelligent. L’optimisation des performances devient critique ici : chaque milliseconde compte lorsqu’une menace active doit être stoppée.
🛠️ Open WebUI et Chroma : démocratiser l’IA locale et contextuelle
Derrière toute cette sophistication se cache une réalité importante : les outils nécessaires pour construire ces systèmes sont désormais gratuits, open source et accessibles à tous. Open WebUI et Chroma forment un tandem puissant, transformant la complexité technique en expérience utilisateur fluide. 🎯
🖥️ Open WebUI : l’interface qui rend l’IA accessible sans code
Open WebUI est une interface web minimaliste mais puissante qui crée un pont entre vous, vos données, et les modèles d’IA locaux. Vous téléchargez vos documents — PDF, Markdown, images, fichiers texte — et l’interface gère automatiquement l’indexation vectorielle, le stockage et l’interrogation. Quelques minutes plus tard, vous conversez avec votre propre assistant contextualisé, sans jamais exposer vos données au cloud. 🌐
Ce qui rend Open WebUI révolutionnaire, c’est qu’aucune connaissance technique n’est requise. Vous n’avez pas besoin de comprendre les embeddings, les vecteurs ou les algorithmes d’indexation. Vous appuyez sur un bouton, sélectionnez votre fichier, et le système fait le reste. C’est à l’IA locale ce que WordPress a été au blogging : une démocratisation transformatrice.
📦 Chroma comme fondation : légère, adaptable, intégrée
Sous le capot, Open WebUI utilise souvent Chroma comme moteur vectoriel. Chroma gère le lourd travail : conversion des documents en embeddings, indexation optimisée, recherche sémantique ultra-rapide. Sa nature Python-first la rend immédiatement intégrable dans des pipelines existants. 🔧
Les développeurs apprécient que Chroma soit assez simple pour un prototype — quelques lignes de code — mais assez robuste pour supporter des déploiements en production. Elle s’intègre naturellement avec LangChain, LlamaIndex et d’autres frameworks IA modernes.
🔄 Le workflow complet : du document à la réponse contextuelle
Le flux est transparent pour l’utilisateur mais techniquement élégant. Un utilisateur importe un PDF de 500 pages sur la réglementation RGPD. Open WebUI le fragmente automatiquement en passages, les vectorise via un modèle d'embedding (localement, sans APIs externes), et les indexe dans Chroma. Lorsque l’utilisateur demande « Quelles sont mes obligations en matière de consentement ? », le système retrouve les sections pertinentes et alimente un LLM local (via Ollama ou vLLM) qui génère une réponse précise. ✨
Tout cela se déroule localement, de manière privée, sans frais de token ou d’API. C’est une démonstration vivante de la façon dont les bases vectorielles transforment l’IA de ressource centralisée à infrastructure personnelle et souveraine.
🎯 Construire votre propre base vectorielle : principes et cas d’usage
La question que se posent de nombreux professionnels est naturelle : faut-il vraiment créer une base vectorielle personnelle ? La réponse dépend de votre contexte, mais pour les auteurs, chercheurs, journalistes et développeurs, les bénéfices sont souvent transformationnels. 💡
🏆 Pourquoi une base vectorielle personnelle fait sens
Imaginez être rédacteur technique depuis dix ans. Vous avez écrit des centaines d’articles, chacun contenant des explications, des comparaisons et des conclusions. Sans base vectorielle, ce savoir reste dispersé dans vos archives, difficile à mobiliser lors de l’écriture d’un nouvel article. Avec une base vectorielle personnelle indexant tous vos contenus passés, vous construisez progressivement une mémoire sémantique propre.
Lorsque vous rédigez, vous pouvez interroger cette mémoire : « Quelle était ma conclusion sur les performances du langage Rust en 2023 ? » ou « Quels exemples ai-je utilisés pour expliquer la synchronisation multithread ? » Le système retrouve vos anciens articles, renforçant la cohérence éditoriale et accélérant votre processus créatif. 📚
Pour les chercheurs, une base vectorielle indexant vos papiers, vos notes et vos données de recherche devient un assistant personnel inestimable. Pour les développeurs, indexer votre codebase et sa documentation crée un moteur de recherche sémantique incomparable aux simples commandes grep.
⚖️ Les limites pragmatiques à connaître
Cependant, créer une base vectorielle pour tout n’a pas de sens. Chaque document vectorisé consomme du stockage, du calcul (initial) et éventuellement de la mémoire RAM. Une base surchargée avec des contenus non pertinents produit du bruit : la recherche retrouve trop de résultats sans rapport, dilutant la pertinence. 🚫
Une approche plus efficace est stratégiquement segmentée. Vous pourriez créer plusieurs bases thématiques : une pour vos articles et publications, une pour la documentation technique, une pour vos notes de recherche. Cette modularité facilite la maintenance et améliore la précision des résultats.
🚀 Setup recommandé : minimaliste et extensible
Pour débuter, une architecture simple suffit : Chroma comme base vectorielle, Ollama ou vLLM pour exécuter un LLM localement, LangChain ou LlamaIndex pour orchestrer le pipeline. Si vous souhaitez une interface visuelle sans code, ajoutez Open WebUI par-dessus. Cette stack est gratuite, open source, et déploiement en quelques minutes sur n’importe quel ordinateur moderne. 💻
À mesure que vos besoins grandissent — plus de documents, latence réduite requise, déploiement distribué — vous pouvez migrer vers Qdrant ou Milvus sans modification majeure du code applicatif. Les frameworks modernes abstraient ces détails d’infrastructure, permettant une évolution progressive.
📈 L’impact métier : au-delà de la technologie
Réduire les bases vectorielles à de la technologie serait superficiel. Leur vrai pouvoir réside dans la transformation des capacités métier. Un guide complet sur les projets RAG en entreprise explore comment ces systèmes génèrent une véritable valeur opérationnelle.
⏱️ Gains d’efficacité mesurables
Les équipes utilisant des assistants alimentés par bases vectorielles rapportent une augmentation concrète de productivité. Les chercheurs retrouvent les informations en minutes au lieu d’heures. Les équipes support résolvent les tickets plus vite. Les analystes identifient des patterns cachés dans des corpus trop volumineux pour l’analyse manuelle. Ces gains ne sont pas théoriques — ils se traduisent en heure économisées et qualité améliorée. 💰
🎓 Capitalisation du savoir tacite
Les organisations ont une mémoire institutionnelle dispersée dans les esprits, les e-mails et les documents mal classés. Une base vectorielle bien structurée capture cette connaissance, la rend accessible et la protège contre le départ des collaborateurs. C’est du savoir capitalisé, exploitable longtemps après son contexte d’origine.
🔮 Innovation accélérée
L’accès facile à une base de connaissances riche encourage l’expérimentation et la réutilisation intelligente. Les équipes découvrent des connexions entre domaines, appliquent des solutions passées à de nouveaux problèmes, et combinent des idées de manière inattendue. C’est un moteur d’innovation incrémentale mais durable. 🌟
🔐 Confidentialité et souveraineté des données : pourquoi local compte
À l’ère des inquiétudes sur la confidentialité des données, le fait que les bases vectorielles open source fonctionnent localement est un atout stratégique majeur. Vos documents, vos embeddings, vos requêtes restent sur votre infrastructure, inaccessibles aux prestataires cloud. 🔒
Pour les organisations manipulant des données sensibles — secteur financier, pharmaceutique, défense, données clientèle — cette souveraineté n’est pas un luxe mais une nécessité légale et éthique. RGPD, HIPAA, lois de conformité locale : l’IA locale offre un cadre de conformité naturel, sans besoin de négociations de clauses ou de certifications complexes.
Même pour les organisations moins réglementées, le fait de conserver le contrôle total de son infrastructure IA offre une tranquillité d’esprit et une indépendance face aux changements de tarification ou aux politiques des prestataires cloud. C’est un argument puissant en faveur des bases vectorielles open source auto-hébergées.
🌐 Intégration avec les frameworks modernes : LangChain, LlamaIndex et au-delà
L’écosystème IA n’existe pas isolément. Les bases vectorielles brillent quand elles s’intègrent harmonieusement avec d’autres composants. La comparaison entre CrewAI et LangChain illustre comment ces frameworks structurent les architectures IA modernes.
🔗 LangChain : l’orchestration transparente
LangChain abstrait la complexité de l’intégration LLM + base vectorielle derrière une interface Python élégante. Un développeur peut construire un pipeline RAG complet en quelques dizaines de lignes, déclarant le LLM, la base vectorielle, les retriever et la stratégie de prompting. LangChain gère les détails, permettant au développeur de se concentrer sur la logique métier. 🛠️
📊 LlamaIndex : la structuration intelligente des documents
LlamaIndex (anciennement GPT Index) va plus loin en structurant intelligemment les documents avant vectorisation. Il crée des index hiérarchiques, analyse la structure des documents, extrait les métadonnées pertinentes. Cette approche produit des recherches plus pertinentes et des résumés plus nuancés. 📋
🤖 CrewAI : l’orchestration multi-agent
CrewAI, plus récent, explore l’orchestration de multiples agents autonomes travaillant de concert. Chacun dispose de son accès à des bases vectorielles spécialisées, des outils et des rôles définis. Cette approche multi-agent augmente la fiabilité, la transparence et la capacité à traiter des problèmes complexes en les décomposant. 🎭
Ces frameworks ne sont pas en compétition : ils adressent des niveaux différents d’abstraction. LangChain convient au rapid prototyping et aux cas simples. LlamaIndex excelle pour l’indexation sophistiquée. CrewAI est optimal pour les systèmes multi-agent complexes. Le choix dépend de votre problématique et de votre préférence architecturale.
📊 Métriques et monitoring : assurer la qualité du système
Comme tout système en production, les bases vectorielles requièrent du monitoring et une optimisation continue. Simplement indexer des documents ne suffit pas ; faut-il s’assurer que la qualité des recherches reste élevée au fil du temps. 📈
🎯 Mesurer la pertinence de la recherche
Les métriques classiques de recherche s’appliquent : précision (quelle fraction des résultats retournés est pertinente), rappel (quelle fraction des documents pertinents a été retrouvée), et F1-score (harmonie entre les deux). Pour les cas d’usage RAG, des métriques additionnelles importent : qualité de la génération (les réponses générées sont-elles factuellement correctes ?) et latence (le temps de réponse impacte-t-il l’expérience utilisateur ?). ⏱️
🔍 Monitoring des embeddings et de la dérive
À mesure que votre base grandit, les embeddings produits par les modèles peuvent évoluer subtilement, particulièrement si vous mettez à jour votre modèle d'embedding. Cette « dérive » peut dégrader progressivement la pertinence des recherches. Monitorer la qualité des embeddings — leur moyenne, leur variance, leur cohérence — aide à détecter ces problèmes avant qu’ils n’impactent gravement les utilisateurs. 📉
💡 Feedback utilisateur comme signal d’optimisation
Le meilleur indicateur de problème est souvent le feedback utilisateur : « Les résultats ne sont pas pertinents », « Cet article ne devrait pas apparaître ici », « Pourquoi l’assistant rate-t-il toujours cette question ? » Ces signaux identifient des cas limite et guident les optimisations. Instrumenter votre système pour capturer ce feedback crée une boucle d’amélioration continue. 🔄
🚀 Perspectives futures : vers une IA véritablement autonome et apprenante
En 2026, l’utilisation des bases vectorielles ne fait que commencer. Les tendances émergentes pointent vers une nouvelle ère où ces systèmes ne sont pas de simples dépôts mais des entités cognitives vivantes, capables d’apprentissage continu et d’autonomie accrue. 🌟
🧬 Mémoire longue durée et formation continue
Les agents IA de demain ne seront pas des tabula rasa à chaque conversation. Ils disposeront de mémoires persistantes, stockées dans des bases vectorielles, permettant de retenir les apprentissages, les erreurs commises et les contextes utilisateur. Cette continuité transforme la relation utilisateur-IA : d’éphémère et stateless à persistante et contextualisée sur le long terme. 📚
⚙️ Recherche hybride et multimodale avancée
Les prochaines générations de bases vectorielles supporteront nativement des recherches combinant texte, images, audio et même vidéo dans un espace sémantique unifié. Un utilisateur pourrait rechercher « me montrer les moments de réunion où ce sujet a été discuté » en interrogant des archives vidéo, texte et audio simultanément. 🎬
🌍 Décentralisation et fédération
À mesure que les préoccupations de souveraineté grandissent, on verra émerger des architectures de bases vectorielles fédérées, où plusieurs instances communiquent tout en restant souveraines. Une organisation pourrait exposer sélectivement des fragments de sa base à des partenaires sans révéler l’ensemble du contenu. 🔐
Ces développements transforment les bases vectorielles de simples accessoires techniques en pilier fondamental d’une nouvelle génération d’IA : adaptative, autonome, respectable de la vie privée et vraiment intelligente au sens cognitif du terme. 🎯
Author Profile
- Signature éditoriale de la rédaction de agentlink.org — nom de plume assumé de l'équipe du site, et non une personne réelle. Les articles publiés sous cette signature sont rédigés avec l'assistance d'une intelligence artificielle, sous la responsabilité éditoriale du site.
Latest entries
 Actus Intelligence Artificielle - Agent IA4 octobre 2026Adoption de l’IA en entreprise : pourquoi les chiffres officiels ne se recoupent pas
 Santé2 octobre 2026Franchise médicale et médicaments à 15 % : ce qui change pour les patients en ALD
 Service29 septembre 2026Feuille de soins par photo sur l’appli ameli : la démarche expliquée
 Gastronomie27 septembre 2026Pâté en croûte, tourtes, vol-au-vent : le grand retour des feuilletés charcutiers
Cet article a été rédigé avec l’aide d’une intelligence artificielle. Politique éditoriale