En resumen — Las bases de datos vectoriales se han convertido en la columna vertebral invisible de la inteligencia artificial moderna. En 2025, estos sistemas de almacenamiento especializados están transformando la manera en que los asistentes inteligentes acceden a la memoria y comprenden el contexto de las consultas. En lugar de simples búsquedas por palabras clave, permiten una búsqueda semántica capaz de captar el sentido profundo de los datos. Esta evolución abre el camino a agentes autónomos dotados de una verdadera memoria persistente, capaces de aprender y evolucionar sin necesidad de un reentrenamiento constante. El mercado mundial alcanzaría los 3.200 millones de dólares en 2025, lo que confirma la importancia estratégica de esta tecnología para las organizaciones que buscan desplegar IA realmente contextuales.
🧠 Por qué las bases de datos vectoriales transforman la memoria de los asistentes inteligentes
Índice
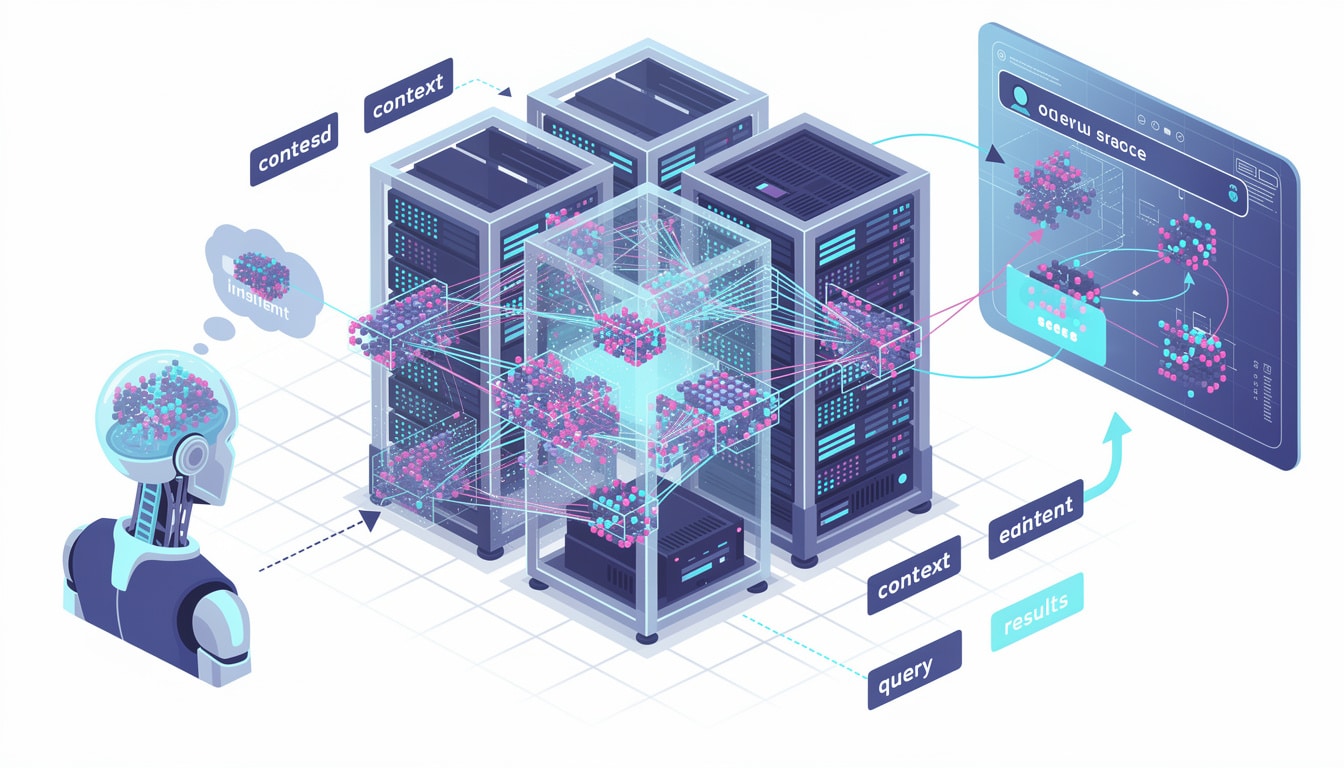
Imagine un asistente de IA capaz de recordar no solo sus palabras exactas, sino de comprender el sentido profundo detrás de su pregunta. Esto es exactamente lo que permiten las bases de datos vectoriales. A diferencia de los sistemas tradicionales que indexan términos individuales, estas almacenan e interrogan representaciones semánticas complejas —vectores matemáticos que capturan la esencia misma del contenido.
Este enfoque revoluciona la manera en que funcionan los asistentes inteligentes. Cuando un usuario formula una pregunta, esta se transforma en un vector numérico y luego se compara con los millones de otros vectores almacenados en la base. La similitud coseno, una medida matemática de proximidad, identifica al instante la información más relevante, incluso si utiliza palabras diferentes. 🎯
Este mecanismo eleva a los asistentes más allá de simples generadores de texto. Se convierten en sistemas dotados de una memoria externa persistente, capaces de consultar archivos, documentaciones o corpus enteros sin olvidar nunca. Esta es la base del RAG (Retrieval-Augmented Generation), un enfoque que combina la potencia lingüística de los LLM con el acceso a un conocimiento actualizado y especializado.
💾 De la simple búsqueda a la comprensión contextual
Un motor de búsqueda clásico funciona mediante correspondencias de términos. Si busca “cómo optimizar el rendimiento de la GPU”, un sistema tradicional le propondrá documentos que contengan exactamente esas palabras. Pero una base vectorial comprende que “acelerar el procesamiento gráfico” y “mejorar la velocidad del procesador visual” hablan del mismo tema. 📊
Esta capacidad de captar los matices semánticos transforma la experiencia del usuario. Los asistentes inteligentes alimentados por estas bases responden con mayor precisión y contexto. Captan las relaciones entre conceptos, distinguen los sinónimos e incluso detectan las sutilezas irónicas o metafóricas que los sistemas más antiguos ignoraban por completo.
Para las organizaciones, esto significa copilotos documentales capaces de interpretar consultas de negocio complejas, sistemas de atención al cliente que comprenden la intención real del solicitante, y asistentes de análisis capaces de vincular información dispersa en miles de documentos. La indexación vectorial se convierte así en una ventaja competitiva importante. 🚀
🔍 Cómo funcionan las bases de datos vectoriales: del texto a la memoria semántica
El funcionamiento de una base vectorial se basa en una cadena tecnológica precisa, donde cada etapa transforma los datos en bruto en representaciones que la IA puede utilizar. Comprender este proceso aclara por qué estos sistemas se han vuelto indispensables para los asistentes modernos.
🔄 La etapa crítica: transformar los datos en embeddings
Todo comienza con la representación semántica de los datos. Un modelo de embedding, como text-embedding-ada-002 o nomic-embed-text, analiza su texto, su imagen o su audio, y los convierte en vectores numéricos. Estos vectores no son aleatorios: encapsulan el significado, el contexto, el tono y las relaciones semánticas. 📝
Considere este ejemplo: la palabra “banco” produce un vector diferente según el contexto. En finanzas, se posiciona cerca de “crédito”, “préstamo” e “interés”. En geografía, se acerca a “río”, “curso de agua” y “orilla”. El modelo de embedding capta estas variaciones gracias a miles de dimensiones matemáticas invisibles al ojo humano.
Este proceso también se aplica a las imágenes. Una foto de un perro genera un vector único que comparte similitudes con otras imágenes de perros, pero se distingue claramente de las imágenes de gatos. Los modelos multimodales amplían esta lógica creando vectores compatibles entre texto e imagen, abriendo el camino a una búsqueda verdaderamente integrada.
⚡ Indexación y optimización para búsquedas ultrarrápidas
Almacenar millones de vectores es una cosa; recuperarlos al instante es otra. Aquí entran en juego las estructuras de índice sofisticadas. Algoritmos como HNSW (Hierarchical Navigable Small World) y la cuantificación de producto crean arquitecturas que permiten buscar los vectores más cercanos en apenas unos milisegundos, incluso en bases con varios miles de millones de entradas. 🚄
Estas optimizaciones son esenciales para los asistentes en tiempo real. Cuando un usuario formula una pregunta, el sistema no puede analizar cada vector de la base: sería demasiado lento. La indexación crea “atajos” matemáticos, vías rápidas que permiten identificar los documentos relevantes sin rebuscar exhaustivamente.
Herramientas como Pinecone, Qdrant y Chroma implementan estas optimizaciones en producción. Qdrant, por ejemplo, utiliza un enfoque basado en Rust que ofrece una latencia extremadamente baja, mientras que Pinecone gestiona arquitecturas en la nube con escalado automático.
🎯 La búsqueda semántica en acción: más allá de las palabras clave
Cuando se formula una pregunta, esta pasa por el mismo proceso: transformación en vector mediante un modelo de embedding. La base calcula entonces la distancia entre ese vector y todos los demás almacenados. Los documentos o fragmentos con la proximidad vectorial más alta salen a la superficie, sin depender de correspondencias léxicas exactas.
Imagine que un asistente debe responder a “¿Cuáles son los mejores enfoques para reducir el consumo energético de los centros de datos?” Su búsqueda encontrará no solo documentos que mencionen explícitamente estos términos, sino también artículos que hablen de eficiencia térmica, refrigeración líquida u optimización de hardware, todos semánticamente alineados.
Esta capacidad de recuperación de información basada en el sentido transforma radicalmente la calidad de las respuestas generadas por los LLM. Los modelos ya no se limitan a su entrenamiento original: acceden dinámicamente a una memoria externa rica, actual y relevante.
🏗️ El ecosistema de código abierto: democratizar el acceso a las bases vectoriales
La innovación en inteligencia artificial se acelera cuando las herramientas se vuelven accesibles. En 2025, el ecosistema de código abierto ha transformado las bases vectoriales de una tecnología propietaria costosa en infraestructura democratizada. Proyectos como FAISS, Chroma, Qdrant y Milvus permiten a desarrolladores, investigadores y pymes desplegar sistemas sofisticados de búsqueda vectorial sin depender de los gigantes de la nube. 💡
📚 FAISS: la potencia bruta de Meta al servicio de todos
FAISS (Facebook AI Similarity Search), desarrollada por Meta, sigue siendo una referencia indispensable para la búsqueda vectorial de alto rendimiento. Escrita en C++ con enlaces en Python, ofrece una velocidad excepcional y una eficiencia de memoria notable, especialmente en GPU. Los equipos que trabajan con volúmenes masivos —millones o miles de millones de vectores— la prefieren por su optimización agresiva. 🔥
Su adopción masiva en proyectos de investigación y sistemas críticos confirma su fiabilidad. FAISS brilla especialmente cuando la latencia debe ser mínima y los recursos computacionales son limitados.
🎨 Chroma: la simplicidad para prototipar e iterar
En el otro extremo del espectro se encuentra Chroma, una base vectorial en Python minimalista pensada para la simplicidad y la integración rápida. Diseñada para funcionar localmente o de forma distribuida, se integra de manera natural con marcos modernos como LangChain, LlamaIndex y Open WebUI. Para quien desee experimentar rápidamente con un asistente RAG o un copiloto documental, Chroma ofrece la curva de aprendizaje más suave. 🚀
Su punto fuerte reside en la accesibilidad: en pocas líneas de Python, puede indexar sus propios documentos y construir un asistente contextualizado capaz de aprovechar su conocimiento interno. Esta simplicidad explica su adopción masiva en proyectos educativos y prototipos empresariales.
⚙️ Qdrant: el equilibrio de producción entre rendimiento y flexibilidad
Escrita en Rust, Qdrant representa la evolución madura de las bases vectoriales de código abierto. Ofrece una API REST y gRPC completa, rendimientos ultrarrápidos y una arquitectura capaz de soportar filtros complejos y búsquedas híbridas (que combinan búsqueda vectorial y criterios estructurados). Para los despliegues en producción que exigen robustez y escalabilidad, Qdrant se impone como una opción estratégica. 🎯
Las organizaciones utilizan Qdrant para alimentar sistemas de recomendación en tiempo real, motores de detección de anomalías y asistentes documentales empresariales. Su ecosistema maduro y su documentación rica facilitan su adopción a gran escala.
🌐 Milvus: la potencia distribuida para entornos críticos
Milvus lleva la ambición más lejos al proponer una arquitectura distribuida diseñada para entornos de producción masivos. Capaz de gestionar varios miles de millones de vectores con alta disponibilidad, tolera fallos y escala horizontalmente. Combinada con Zilliz Cloud (su versión gestionada), representa la solución para las organizaciones que han superado los límites de una sola máquina. 💪
Su creciente adopción en los sectores financiero, farmacéutico y tecnológico confirma su madurez y fiabilidad en condiciones extremas.
🤖 Del RAG clásico al Agentic RAG: la memoria en el centro de la autonomía
La evolución de las bases vectoriales no se detiene en la búsqueda. Impulsa una transformación arquitectónica profunda: la de los asistentes simples hacia los agentes autónomos dotados de una verdadera memoria cognitiva. Los agentes autónomos y la automatización representan la frontera actual de esta evolución.
🔗 RAG: el fundamento — consulta y generación
El Retrieval-Augmented Generation (RAG) clásico funciona en tres etapas sencillas. El usuario formula una pregunta; esta se vectoriza y se busca en la base; los fragmentos relevantes alimentan el prompt del LLM, que genera una respuesta contextual. Es lineal, predecible y sorprendentemente eficaz para una amplia gama de casos de uso. 📋
Imagine una empresa con miles de documentos técnicos. Sin RAG, un asistente genérico ignoraría este conocimiento especializado. Con RAG y una base vectorial, el asistente se convierte al instante en experto, encontrando las secciones relevantes y construyendo respuestas ancladas en la realidad de la organización.
🧩 Agent RAG: la toma de decisiones y la planificación
El Agent RAG da un paso más. En lugar de realizar una única búsqueda, el agente decide dinámicamente cuándo consultar la base, cómo combinar varios resultados y si es necesaria una nueva búsqueda. Se vuelve capaz de razonar sobre sus propias respuestas, detectar contradicciones y planificar varias etapas de búsqueda. 🎲
Marcos como LangGraph y OpenDevin implementan esta lógica, permitiendo a los agentes construir planes complejos: “Primero buscaré la documentación de la API. Luego verificaré los ejemplos de código. Por último, cotejaré esta información con las preguntas frecuentes de los usuarios.” Esta capacidad de planificación eleva la inteligencia más allá de lo reactivo hacia lo proactivo.
🧠 Agentic RAG: la memoria viva y el autoaprendizaje
El Agentic RAG representa el apogeo: un bucle cerrado en el que el agente observa su entorno, razona, actúa y luego actualiza su propia memoria vectorial. Este ciclo crea una forma de inteligencia adaptativa y autónoma. El agente registra sus descubrimientos, sus errores, sus éxitos, construyendo progresivamente una base de conocimiento experiencial. 🌟
En concreto, un agente de vigilancia podría indexar automáticamente los artículos detectados, analizar las tendencias, identificar las anomalías y memorizar sus conclusiones para orientar sus análisis futuros. El Agentic RAG transforma la relación entre conocimiento y decisión: la memoria vectorial ya no es estática, sino viva, evolutiva, reflejo de la experiencia acumulada.
🌍 Casos de uso reales: cómo las bases vectoriales reinventan los asistentes en las empresas
La teoría es convincente, pero es observando los despliegues reales que el potencial se vuelve tangible. A través de distintos sectores, las bases vectoriales transforman la manera en que las organizaciones construyen sus asistentes inteligentes. La estrategia de integración de los agentes autónomos muestra cómo las empresas estructuran estas transformaciones.
📄 Asistentes documentales: consultar el pasado en segundos
Una empresa farmacéutica dispone de 50 años de archivos —patentes, estudios clínicos, informes de cumplimiento, correspondencia regulatoria. Tradicionalmente, encontrar un documento específico tardaba días. Con una base vectorial que alimenta un asistente, un investigador simplemente pregunta “¿Cuáles son los antecedentes de esta molécula en nuestros archivos?”, y el sistema encuentra los fragmentos relevantes entre millones de páginas. 🔬
Este escenario se repite en los bufetes de abogados (búsqueda de jurisprudencia), las agencias de contenido (encontrar artículos anteriores) y los departamentos de RR. HH. (explorar políticas pasadas). El aprendizaje automático ya no se reserva a la predicción: se convierte en una herramienta de redescubrimiento y aprovechamiento del patrimonio informativo existente.
💬 Atención al cliente contextualizada: comprender realmente el problema
Un asistente de atención al cliente alimentado por una base vectorial de 100.000 tickets pasados comprende que “la app ya no funciona en mi teléfono viejo” e “incompatibilidad de versión” describen el mismo problema. Encuentra al instante las soluciones probadas, propone pasos de resolución precisos y, si el cliente no queda satisfecho, escala de forma inteligente a un humano con todo el contexto relevante. 🎧
El efecto es medible: reducción del tiempo medio de resolución, mayor satisfacción del cliente, menor carga sobre los equipos. Las organizaciones que han implementado este enfoque reportan habitualmente una mejora del 30-40% en eficiencia.
🔐 Análisis de seguridad y detección de anomalías
En ciberseguridad, una base vectorial indexa los informes de incidentes pasados, las firmas de malware y los patrones de ataques conocidos. Cuando surge una nueva amenaza, el sistema la vectoriza y la compara con las miles de amenazas anteriores. Identifica similitudes inadvertidas en el análisis manual, alertando a los equipos sobre conexiones ocultas. 🛡️
Esto transforma la detección de anomalías de una tarea laboriosa en un proceso continuo e inteligente. La optimización del rendimiento se vuelve crítica aquí: cada milisegundo cuenta cuando hay que detener una amenaza activa.
🛠️ Open WebUI y Chroma: democratizar la IA local y contextual
Detrás de toda esta sofisticación se esconde una realidad importante: las herramientas necesarias para construir estos sistemas son hoy gratuitas, de código abierto y accesibles para todos. Open WebUI y Chroma forman un tándem potente, transformando la complejidad técnica en una experiencia de usuario fluida. 🎯
🖥️ Open WebUI: la interfaz que hace accesible la IA sin código
Open WebUI es una interfaz web minimalista pero potente que crea un puente entre usted, sus datos y los modelos de IA locales. Usted sube sus documentos —PDF, Markdown, imágenes, archivos de texto— y la interfaz gestiona automáticamente la indexación vectorial, el almacenamiento y la consulta. Unos minutos más tarde, conversa con su propio asistente contextualizado, sin exponer nunca sus datos a la nube. 🌐
Lo que hace revolucionario a Open WebUI es que no se requiere ningún conocimiento técnico. No necesita entender los embeddings, los vectores ni los algoritmos de indexación. Pulsa un botón, selecciona su archivo, y el sistema hace el resto. Es a la IA local lo que WordPress fue al blogging: una democratización transformadora.
📦 Chroma como fundamento: ligero, adaptable, integrado
Bajo el capó, Open WebUI utiliza a menudo Chroma como motor vectorial. Chroma se encarga del trabajo pesado: conversión de documentos en embeddings, indexación optimizada, búsqueda semántica ultrarrápida. Su naturaleza Python-first la hace inmediatamente integrable en pipelines existentes. 🔧
Los desarrolladores aprecian que Chroma sea lo bastante simple para un prototipo —unas pocas líneas de código— pero lo bastante robusta para soportar despliegues en producción. Se integra de forma natural con LangChain, LlamaIndex y otros marcos de IA modernos.
🔄 El flujo completo: del documento a la respuesta contextual
El flujo es transparente para el usuario, pero técnicamente elegante. Un usuario importa un PDF de 500 páginas sobre la normativa RGPD (el reglamento europeo de protección de datos). Open WebUI lo fragmenta automáticamente en pasajes, los vectoriza mediante un modelo de embedding (localmente, sin APIs externas) y los indexa en Chroma. Cuando el usuario pregunta “¿Cuáles son mis obligaciones en materia de consentimiento?”, el sistema encuentra las secciones relevantes y alimenta un LLM local (vía Ollama o vLLM) que genera una respuesta precisa. ✨
Todo esto ocurre localmente, de forma privada, sin costes de token ni de API. Es una demostración viva de cómo las bases vectoriales transforman la IA de un recurso centralizado a una infraestructura personal y soberana.
🎯 Construir su propia base vectorial: principios y casos de uso
La pregunta que se hacen muchos profesionales es natural: ¿hace falta realmente crear una base vectorial personal? La respuesta depende de su contexto, pero para autores, investigadores, periodistas y desarrolladores, los beneficios suelen ser transformadores. 💡
🏆 Por qué una base vectorial personal tiene sentido
Imagine ser redactor técnico desde hace diez años. Ha escrito centenares de artículos, cada uno con explicaciones, comparaciones y conclusiones. Sin una base vectorial, ese conocimiento permanece disperso en sus archivos, difícil de movilizar al escribir un nuevo artículo. Con una base vectorial personal que indexa todos sus contenidos pasados, construye progresivamente una memoria semántica propia.
Cuando redacta, puede consultar esa memoria: “¿Cuál era mi conclusión sobre el rendimiento del lenguaje Rust en 2023?” o “¿Qué ejemplos utilicé para explicar la sincronización multihilo?” El sistema recupera sus artículos anteriores, reforzando la coherencia editorial y acelerando su proceso creativo. 📚
Para los investigadores, una base vectorial que indexa sus artículos, sus notas y sus datos de investigación se convierte en un asistente personal inestimable. Para los desarrolladores, indexar su base de código y su documentación crea un motor de búsqueda semántica incomparable con los simples comandos grep.
⚖️ Los límites pragmáticos que hay que conocer
Sin embargo, crear una base vectorial para todo no tiene sentido. Cada documento vectorizado consume almacenamiento, cálculo (inicial) y eventualmente memoria RAM. Una base sobrecargada con contenidos irrelevantes produce ruido: la búsqueda encuentra demasiados resultados sin relación, diluyendo la relevancia. 🚫
Un enfoque más eficaz es el segmentado estratégicamente. Podría crear varias bases temáticas: una para sus artículos y publicaciones, otra para la documentación técnica, otra para sus notas de investigación. Esta modularidad facilita el mantenimiento y mejora la precisión de los resultados.
🚀 Configuración recomendada: minimalista y extensible
Para empezar, basta con una arquitectura sencilla: Chroma como base vectorial, Ollama o vLLM para ejecutar un LLM localmente, LangChain o LlamaIndex para orquestar el pipeline. Si desea una interfaz visual sin código, añada Open WebUI por encima. Este stack es gratuito, de código abierto, y se despliega en pocos minutos en cualquier ordenador moderno. 💻
A medida que sus necesidades crecen —más documentos, menor latencia requerida, despliegue distribuido— puede migrar a Qdrant o Milvus sin modificaciones importantes en el código de la aplicación. Los marcos modernos abstraen estos detalles de infraestructura, permitiendo una evolución progresiva.
📈 El impacto empresarial: más allá de la tecnología
Reducir las bases vectoriales a mera tecnología sería superficial. Su verdadero poder reside en la transformación de las capacidades empresariales. Una guía completa sobre los proyectos RAG en la empresa explora cómo estos sistemas generan un verdadero valor operativo.
⏱️ Ganancias de eficiencia medibles
Los equipos que utilizan asistentes alimentados por bases vectoriales reportan un aumento concreto de productividad. Los investigadores encuentran la información en minutos en lugar de horas. Los equipos de soporte resuelven los tickets más rápido. Los analistas identifican patrones ocultos en corpus demasiado voluminosos para el análisis manual. Estas ganancias no son teóricas: se traducen en horas ahorradas y calidad mejorada. 💰
🎓 Capitalización del conocimiento tácito
Las organizaciones tienen una memoria institucional dispersa en las mentes, los correos electrónicos y los documentos mal clasificados. Una base vectorial bien estructurada captura ese conocimiento, lo hace accesible y lo protege frente a la salida de colaboradores. Es conocimiento capitalizado, explotable mucho después de su contexto original.
🔮 Innovación acelerada
El acceso fácil a una base de conocimiento rica fomenta la experimentación y la reutilización inteligente. Los equipos descubren conexiones entre dominios, aplican soluciones pasadas a nuevos problemas y combinan ideas de manera inesperada. Es un motor de innovación incremental pero duradera. 🌟
🔐 Privacidad y soberanía de los datos: por qué lo local importa
En una era de preocupación por la privacidad de los datos, el hecho de que las bases vectoriales de código abierto funcionen localmente es una ventaja estratégica importante. Sus documentos, sus embeddings, sus consultas permanecen en su infraestructura, inaccesibles para los proveedores de la nube. 🔒
Para las organizaciones que manejan datos sensibles —sector financiero, farmacéutico, defensa, datos de clientes— esta soberanía no es un lujo, sino una necesidad legal y ética. El RGPD (reglamento europeo de protección de datos), la HIPAA, las leyes de cumplimiento locales: la IA local ofrece un marco de cumplimiento natural, sin necesidad de negociar cláusulas ni certificaciones complejas.
Incluso para las organizaciones menos reguladas, mantener el control total de su infraestructura de IA ofrece tranquilidad e independencia frente a cambios de tarifas o políticas de los proveedores en la nube. Es un argumento poderoso en favor de las bases vectoriales de código abierto autohospedadas.
🌐 Integración con marcos modernos: LangChain, LlamaIndex y más allá
El ecosistema de IA no existe de forma aislada. Las bases vectoriales brillan cuando se integran armoniosamente con otros componentes. La comparación entre CrewAI y LangChain ilustra cómo estos marcos estructuran las arquitecturas de IA modernas.
🔗 LangChain: la orquestación transparente
LangChain abstrae la complejidad de la integración LLM + base vectorial detrás de una interfaz Python elegante. Un desarrollador puede construir un pipeline RAG completo en unas pocas decenas de líneas, declarando el LLM, la base vectorial, los retriever y la estrategia de prompting. LangChain gestiona los detalles, permitiendo al desarrollador concentrarse en la lógica de negocio. 🛠️
📊 LlamaIndex: la estructuración inteligente de los documentos
LlamaIndex (antes GPT Index) va más allá al estructurar inteligentemente los documentos antes de la vectorización. Crea índices jerárquicos, analiza la estructura de los documentos, extrae los metadatos relevantes. Este enfoque produce búsquedas más pertinentes y resúmenes más matizados. 📋
🤖 CrewAI: la orquestación multiagente
CrewAI, más reciente, explora la orquestación de múltiples agentes autónomos que trabajan conjuntamente. Cada uno dispone de su propio acceso a bases vectoriales especializadas, herramientas y roles definidos. Este enfoque multiagente aumenta la fiabilidad, la transparencia y la capacidad de abordar problemas complejos descomponiéndolos. 🎭
Estos marcos no compiten entre sí: abordan niveles diferentes de abstracción. LangChain es adecuado para el prototipado rápido y los casos sencillos. LlamaIndex destaca en la indexación sofisticada. CrewAI es óptimo para sistemas multiagente complejos. La elección depende de su problemática y de su preferencia arquitectónica.
📊 Métricas y monitorización: garantizar la calidad del sistema
Como todo sistema en producción, las bases vectoriales requieren monitorización y una optimización continua. Indexar documentos simplemente no es suficiente; hay que asegurarse de que la calidad de las búsquedas se mantenga alta con el tiempo. 📈
🎯 Medir la relevancia de la búsqueda
Se aplican las métricas clásicas de búsqueda: precisión (qué fracción de los resultados devueltos es relevante), recall (qué fracción de los documentos relevantes se ha recuperado) y F1-score (armonía entre ambas). Para los casos de uso de RAG, importan métricas adicionales: calidad de la generación (¿son las respuestas generadas correctas desde el punto de vista factual?) y latencia (¿afecta el tiempo de respuesta a la experiencia del usuario?). ⏱️
🔍 Monitorización de los embeddings y la deriva
A medida que su base crece, los embeddings producidos por los modelos pueden evolucionar sutilmente, especialmente si actualiza su modelo de embedding. Esta “deriva” puede degradar progresivamente la relevancia de las búsquedas. Monitorizar la calidad de los embeddings —su media, su varianza, su coherencia— ayuda a detectar estos problemas antes de que afecten gravemente a los usuarios. 📉
💡 El feedback del usuario como señal de optimización
El mejor indicador de un problema suele ser el feedback del usuario: “Los resultados no son relevantes”, “Este artículo no debería aparecer aquí”, “¿Por qué el asistente siempre falla en esta pregunta?” Estas señales identifican casos límite y orientan las optimizaciones. Instrumentar su sistema para capturar este feedback crea un bucle de mejora continua. 🔄
🚀 Perspectivas futuras: hacia una IA verdaderamente autónoma y que aprende
En 2026, el uso de las bases vectoriales no ha hecho más que empezar. Las tendencias emergentes apuntan hacia una nueva era en la que estos sistemas no son simples depósitos, sino entidades cognitivas vivas, capaces de aprendizaje continuo y de mayor autonomía. 🌟
🧬 Memoria de larga duración y formación continua
Los agentes de IA del futuro no serán una tabula rasa en cada conversación. Dispondrán de memorias persistentes, almacenadas en bases vectoriales, que les permitirán retener los aprendizajes, los errores cometidos y los contextos del usuario. Esta continuidad transforma la relación usuario-IA: de efímera y sin estado a persistente y contextualizada a largo plazo. 📚
⚙️ Búsqueda híbrida y multimodal avanzada
Las próximas generaciones de bases vectoriales soportarán de forma nativa búsquedas que combinen texto, imágenes, audio e incluso vídeo en un espacio semántico unificado. Un usuario podría buscar “muéstrame los momentos de reunión en los que se discutió este tema” consultando archivos de vídeo, texto y audio simultáneamente. 🎬
🌍 Descentralización y federación
A medida que crecen las preocupaciones de soberanía, veremos surgir arquitecturas de bases vectoriales federadas, en las que varias instancias se comunican mientras permanecen soberanas. Una organización podría exponer selectivamente fragmentos de su base a socios sin revelar la totalidad del contenido. 🔐
Estos desarrollos transforman las bases vectoriales de simples accesorios técnicos en un pilar fundamental de una nueva generación de IA: adaptativa, autónoma, respetuosa con la privacidad y verdaderamente inteligente en el sentido cognitivo del término. 🎯
Author Profile
Latest entries
 Servicio20 November 2026Crédito al consumo: minicréditos, pago fraccionado y descubierto mejor regulados
 Planeta15 November 2026Emisiones de CO2: por qué el transporte sigue siendo el punto negro del clima en Francia
 Inteligencia Artificial12 November 2026Imagine Enterprise: IBM y Microsoft unen sus agentes de IA para las grandes empresas
 Economía11 November 2026Tipo del Livret A: cómo se calcula y cuáles son sus límites
Este artículo ha sido redactado con la ayuda de una inteligencia artificial. Política editorial