En resumen — Los sistemas multiagente representan uno de los avances más concretos de la IA empresarial. Varias inteligencias artificiales autónomas colaboran para llevar a cabo flujos de trabajo complejos que ningún agente aislado podría gestionar eficazmente. Este enfoque exige un dominio arquitectónico riguroso: definir el blast radius (radio de impacto) de cada agente, implementar guardrails sólidos y elegir el patrón de coordinación adecuado (jerárquico o descentralizado) condiciona el éxito del despliegue. Frameworks como CrewAI y LangGraph permiten construir estos sistemas, pero sin una gobernanza clara de los permisos y las acciones, el riesgo de propagación de errores o de consumo incontrolado de recursos se vuelve crítico.
Para recordar — 🔑 Las arquitecturas jerárquicas dominan el entorno empresarial por su previsibilidad; 🎯 el blast radius debe definirse antes de cualquier despliegue en producción; 🛡️ los guardrails y los kill switches no son negociables; 💡 la memoria compartida entre agentes debe protegerse como cualquier otro dato sensible; ⚙️ los patrones de coordinación (handoff, delegation, pub/sub) determinan la escalabilidad y la depurabilidad del sistema.
🏗️ Los cimientos arquitectónicos de una inteligencia distribuida eficaz
Índice
Cuando una organización se plantea desplegar un sistema multiagente, no se limita a crear varios chatbots independientes. Diseña una infraestructura de software distribuida en la que cada componente debe comunicarse, compartir contexto y coordinar sus acciones sin generar caos. Esa es la diferencia fundamental entre un agente único de buen rendimiento y una red de agentes coherente.
Un agente aislado funciona como un experto ante un problema: moviliza sus conocimientos, sus herramientas y su razonamiento para producir una respuesta. Pero una tarea compleja —análisis de la competencia, gestión de una crisis de seguridad, automatización de un proceso de negocio con varias etapas— raras veces exige una sola competencia. Un análisis en profundidad de las necesidades del negocio revela siempre que el trabajo se descompone de forma natural: búsqueda de datos, estructuración, validación, redacción, aprobación. Ahí es donde entran en juego las arquitecturas de software multiagente.
La clave está en modelar correctamente el sistema. Cada agente debe tener un rol distinto, herramientas especializadas y límites claros de responsabilidad. Un agente orquestador puede coordinar el conjunto, repartiendo las subtareas y sintetizando los resultados. Los agentes especializados ejecutan su misión sin cargar con los detalles de los demás. Esta separación de responsabilidades mejora no solo el rendimiento global, sino también la mantenibilidad y la seguridad del sistema.

⚙️ Los tres pilares de una arquitectura modular exitosa
La arquitectura modular se basa en tres elementos interdependientes: la descomposición clara de las tareas, la especialización de los agentes y la interoperabilidad de los componentes. Si falta cualquiera de los tres, el sistema se fragmenta o se vuelve rígido.
La descomposición de las tareas debe reflejar la realidad del negocio. Imagine un equipo humano gestionando una solicitud compleja de un cliente: el responsable recibe la solicitud, la reparte entre un especialista técnico, un comercial y un operativo. Cada uno aporta su parte y el responsable sintetiza el resultado. Esta misma lógica se aplica a los agentes. El orquestador debe ser capaz de reconocer las etapas necesarias, identificar qué agente es competente para cada una y agregar los resultados.
La especialización significa que cada agente utiliza las herramientas adecuadas para su misión. Un agente de búsqueda solo necesita acceso a motores de búsqueda y bases de datos. Un agente de redacción no requiere herramientas de cálculo complejas. Esta granularidad reduce la superficie de ataque, limita los permisos innecesarios y optimiza los recursos consumidos. Un sistema en el que todos los agentes tienen acceso a todas las herramientas es un sistema vulnerable e ineficaz.
La interoperabilidad define cómo se comunican estos agentes. Los mensajes deben estar estructurados y los contratos deben ser claros. Un agente que transmite sus resultados al siguiente debe garantizar que su output respeta el formato esperado. La serialización JSON, los esquemas de validación y los protocolos de comunicación explícitos son la base de una integración fiable.
🔀 Arquitectura jerárquica frente a modelo descentralizado: ¿qué paradigma elegir?
Actualmente predominan dos filosofías de organización: la jerarquía centralizada y el modelo descentralizado (swarm). Cada una responde a necesidades distintas y presenta sus propias ventajas e inconvenientes.
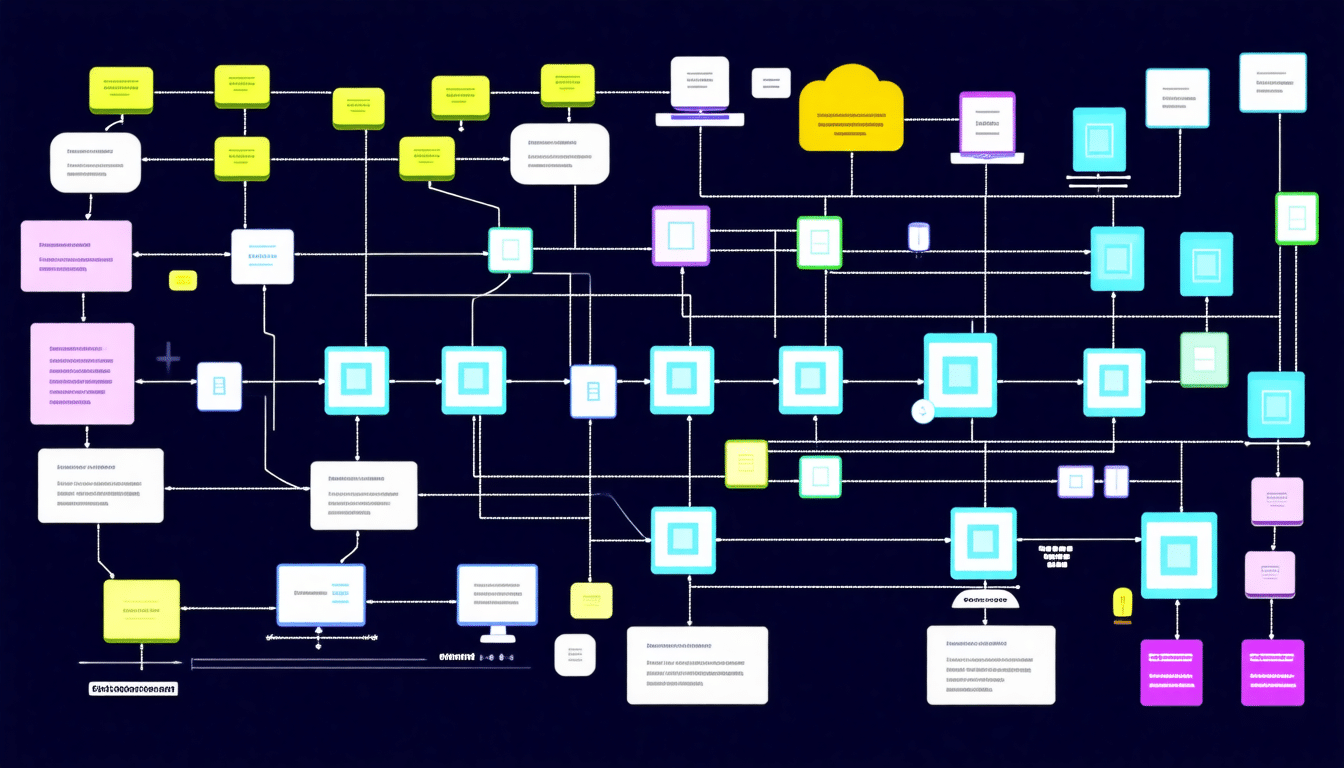
La arquitectura jerárquica concentra el control en un agente orquestador central que descompone cada problema complejo en subtareas y delega el trabajo en agentes especializados. Este orquestador mantiene el contexto global, verifica los resultados intermedios y toma las decisiones críticas. La orquestación multiagente centraliza así la lógica de negocio. La ventaja principal: la previsibilidad. Se sabe exactamente cómo se encadenan las tareas, quién hace qué y dónde buscar cuando algo falla. La depuración se vuelve manejable. Los guardrails se aplican principalmente sobre el orquestador, que actúa como un punto de control único.
El inconveniente: el orquestador se convierte en un cuello de botella. Si la descomposición de las tareas está mal pensada, o si el orquestador debe esperar los resultados de todos los agentes antes de avanzar, el sistema pierde su capacidad de paralelismo. Además, si el orquestador falla, todo el flujo de trabajo se detiene. En producción, esto representa un riesgo real.
El modelo descentralizado (swarm) funciona de otra manera. Los agentes están en el mismo nivel jerárquico y se comunican directamente entre sí según sus necesidades. No hay un orquestador central, sino una autoorganización emergente. Cuando un agente necesita una determinada experiencia, contacta con otros agentes capaces de proporcionarla. Sus ventajas: una mayor resiliencia (no hay un único punto de fallo), una flexibilidad adaptativa (los agentes ajustan su colaboración en tiempo real) y una escalabilidad natural (añadir un nuevo agente especializado no perturba la arquitectura).
Pero aquí está el reto: el comportamiento se vuelve menos previsible. Sin coordinación central, los agentes corren el riesgo de crear bucles infinitos, duplicar trabajo o divergir en sus objetivos. Auditar un sistema descentralizado en producción resulta más complicado. Las alucinaciones de un agente pueden propagarse a otros sin control centralizado. Por estas razones, los despliegues empresariales privilegian mayoritariamente la arquitectura jerárquica. Se adapta mejor a las necesidades de gobernanza y trazabilidad que exigen los contextos críticos.
📊 Jerarquía frente a descentralización: los casos de uso determinantes
¿Cuándo optar por la jerarquía? En cuanto existe un proceso de negocio claro con etapas secuenciales o dependencias fuertes entre tareas. Un proceso de contratación (cribado de CV → entrevista → evaluación → oferta) sigue una secuencia lógica. Un orquestador dirige esa secuencia haciendo avanzar las candidaturas. Los riesgos de desviación son limitados porque cada etapa tiene un objetivo bien definido.
¿Cuándo explorar lo descentralizado? Para problemas de optimización combinatoria, simulaciones complejas o entornos muy dinámicos. Una simulación de evolución de un ecosistema en la que decenas de agentes representan especies que interactúan se beneficia de la autoorganización. Cada agente «criatura» ajusta su comportamiento según su entorno local, sin necesidad de un coordinador global. La emergencia produce patrones interesantes.
En la práctica, muchos sistemas empresariales adoptan un enfoque híbrido: una jerarquía flexible con algunas zonas de descentralización. El SOC agéntico descrito en este análisis en profundidad de los sistemas multiagente autónomos sigue este modelo. El orquestador clasifica las alertas y asigna las investigaciones, pero los agentes de investigación se comunican directamente con las bases de threat intelligence sin pasar por el orquestador cada vez.
🔐 Delimitar el blast radius: la práctica de seguridad innegociable
El blast radius de un agente autónomo es el impacto máximo que sus acciones pueden provocar si algo se descontrola. Definir ese radio y limitarlo técnicamente es la práctica de seguridad fundamental para los sistemas multiagente en producción. Sin ella, el error de un agente puede contaminar todo el sistema.
Imagine un agente encargado de optimizar los precios en una tienda online. Si ese agente mal calibrado decide que los precios deben reducirse un 90 % para maximizar las ventas, puede arruinar la empresa en pocas horas. El blast radius incluye aquí: los datos de precios que puede modificar, el alcance de los descuentos autorizados y el importe total de descuento por día. Cada dimensión debe acotarse explícitamente antes del despliegue.
El blast radius se desglosa en cuatro dimensiones: datos que puede afectar (qué tablas de la base de datos, qué archivos, qué sistemas puede modificar el agente), acciones irreversibles (¿puede enviar correos, eliminar registros, ejecutar código en producción?), recursos consumibles (¿puede llamar a APIs facturadas por uso sin límites?) y perímetro de red (¿con qué sistemas externos puede contactar?).
Para cada dimensión, establezca límites precisos. El agente solo puede modificar los precios de una categoría específica, los descuentos no pueden superar el 30 %, el presupuesto diario total se limita a 1.000 €, y solo un subconjunto de APIs internas resulta accesible. Estas restricciones se codifican mediante listas de control de acceso (ACL), validaciones de esquema y límites de recursos en el runtime del agente.
📋 Cinco niveles de autonomía y sus guardrails asociados
El modelo clásico distingue cinco niveles de autonomía, cada uno de los cuales requiere guardrails distintos. El nivel 1 (solo lectura): el agente solo puede leer datos. No es posible ninguna acción destructiva. Basta un simple control de acceso de lectura. Los agentes de búsqueda y análisis funcionan habitualmente en este nivel.
El nivel 2 (acciones reversibles): el agente puede modificar datos, pero los cambios pueden revertirse. Crear borradores, añadir anotaciones, rellenar formularios de staging. Los guardrails incluyen un registro detallado y límites flexibles de recursos. Se puede auditar todas las modificaciones y deshacerlas si es necesario.
El nivel 3 (acciones semirreversibles): las modificaciones pueden afectar a los sistemas de producción pero siguen siendo parcialmente reversibles. Crear tickets de soporte, enviar notificaciones, actualizar un comentario. Los guardrails combinan rate limiting (el agente solo puede crear X tickets por hora), validación asíncrona (un equipo humano valida los tickets creados) y una trazabilidad completa.
El nivel 4 (acciones irreversibles): modificaciones permanentes sin posibilidad de anulación. Enviar un correo, realizar un pago, desplegar código en producción. En este nivel, el human-in-the-loop se vuelve obligatorio. El agente genera una recomendación de acción con contexto y justificación, y luego espera la aprobación explícita de una persona antes de ejecutarla. Los timeouts son críticos: si la aprobación no llega en 24 horas, la acción se cancela automáticamente.
Cada organización debe situar a sus agentes en esta escala e implementar los guardrails correspondientes. Un agente mal clasificado —dar a un agente de nivel 2 los permisos de un nivel 4— crea un riesgo desproporcionado.
🛡️ Guardrails y kill switches: los mecanismos de control en producción
Los guardrails son las barreras de protección que impiden que un agente cause daño. A diferencia de un agente único, un sistema multiagente presenta vectores de error específicos: un output defectuoso de un agente puede propagar errores a los agentes siguientes, generando auténticas avalanchas de daños. Los guardrails deben operar en varios niveles.
El guardrail 1: validación entre agentes. Cuando el agente A transmite su resultado al agente B, hay que validar que ese output respeta las restricciones esperadas. Si un agente de cálculo devuelve un valor aberrante (10 millones de euros para un presupuesto trimestral de 50.000 €), la transmisión se bloquea y se lanza una alerta. Esta validación puede implementarse mediante esquemas JSON estrictamente tipados o funciones de validación explícitas.
El guardrail 2: timeouts. Cada agente y el flujo de trabajo global deben tener timeouts. Un flujo de trabajo que se ejecuta sin fin consume recursos indefinidamente. Un timeout global de 5 minutos implica que, si el flujo no ha terminado, se interrumpe y se liberan los recursos. Los timeouts por agente permiten detectar cuál de ellos bloquea el sistema. Cuando un agente supera su timeout, se emite una alerta y el equipo de operaciones puede investigar.
El guardrail 3: kill switch central. Accesible a los operadores humanos, este mecanismo detiene instantáneamente todos los agentes en curso. En producción, debe ser posible pulsar el botón rojo ante cualquier comportamiento anómalo detectado (por ejemplo, un agente que empieza a enviar miles de correos). Este kill switch debe ser sencillo, sin confirmaciones en varios pasos (que ralentizarían la reacción), pero registrado para su auditoría.
El guardrail 4: presupuesto de acciones. Limitar el número total de llamadas a herramientas o de iteraciones que puede realizar un flujo de trabajo. Si un agente debería llamar a la API de búsqueda un máximo de 5 veces pero intenta hacerlo 1.000, el presupuesto se agota y el flujo se detiene. Este mecanismo previene los costosos bucles infinitos en los que un agente se plantea preguntas sin fin, cada una de las cuales genera una llamada a la API.
Estos guardrails se implementan en la capa de runtime que ejecuta a los agentes, mediante decoradores de Python, middlewares en el framework (CrewAI y LangGraph incluyen hooks para esto) o proxies de red que inspeccionan y validan las llamadas salientes.
🚨 Detección de anomalías: la monitorización continua del comportamiento agéntico
Los guardrails estáticos (validación de esquemas, timeouts fijos) no son suficientes. Un agente puede comportarse técnicamente de forma correcta y, aun así, producir resultados claramente erróneos. La monitorización continua detecta esas desviaciones.
Cada llamada a una herramienta por parte de un agente debe registrarse: qué agente, qué herramienta, qué argumentos, qué resultado y cuándo. Estos registros alimentan un sistema de detección de anomalías. Las alertas se activan ante patrones anómalos: el agente de búsqueda que de repente llama a su API 100 veces por minuto (frente a su media de 2-3 por minuto), el agente de redacción que accede a una base de datos de RR. HH. que nunca había consultado, los intentos de acceso a recursos no autorizados. Estas señales débiles, detectadas en tiempo real, permiten intervenir antes de que se produzca un daño mayor.
La integración en el SIEM de la organización (Splunk, ELK, Microsoft Sentinel) centraliza esta monitorización. Los agentes autónomos se tratan como entidades de seguridad de pleno derecho: sus acciones se auditan como las de las cuentas de servicio con privilegios.
💬 Patrones de comunicación: la orquestación del trabajo entre agentes
¿Cómo coordinan en la práctica su trabajo los agentes? La respuesta depende del patrón de comunicación elegido. Cada patrón supone un equilibrio entre simplicidad, rendimiento y robustez.
El patrón Handoff es el más sencillo. El agente A termina su tarea, genera un mensaje estructurado (contexto acumulado, resultados, próximos pasos recomendados) y lo transmite al agente B. B recibe ese mensaje como contexto inicial y continúa. Es lineal, previsible y fácil de depurar. Pero también es secuencial: hasta que A no termina, B no puede empezar. No hay paralelismo posible.
El patrón Delegation: el agente orquestador conserva el control. Delega subtareas en agentes especializados y espera los resultados. Una vez recibidos, los integra en su contexto y continúa. Es el patrón dominante en el entorno empresarial. El orquestador gestiona las excepciones (si un agente falla, puede reintentarlo o escalarlo) y mantiene la coherencia global. El coste: el orquestador se convierte en un cuello de botella. Pero la trazabilidad y el control son excelentes.
El patrón Pub/Sub (orientado a eventos): los agentes publican sus resultados como eventos en determinados topics. Los demás agentes se suscriben a los topics que les interesan y reaccionan automáticamente. Un agente de pricing publica «precio_actualizado» y todos los agentes afectados se actualizan. Es muy escalable y desacoplado. Pero el flujo de control no es lineal, lo que dificulta la depuración y aumenta el riesgo de bucles.
El patrón Voting/Consensus: varios agentes independientes analizan el mismo problema y sus respuestas se fusionan mediante votación o síntesis. Es muy robusto frente a las alucinaciones aisladas de un agente (si 3 de cada 5 agentes dicen lo mismo, probablemente sea correcto). Pero resulta muy costoso: N veces el coste en tokens. Se reserva para las decisiones críticas.
Ningún patrón es universalmente mejor que los demás. La elección depende de la topología del negocio. Un flujo de trabajo estructurado (contratación, procesamiento de facturas) se adapta bien al delegation. Un sistema de monitorización distribuido en el que varios sensores publican métricas se adapta bien al pub/sub. Los sistemas críticos y resilientes se apoyan en el voting para las decisiones principales.
🧠 Memoria y persistencia: la arquitectura del conocimiento colectivo
A diferencia de un agente único con una conversación continua, un sistema multiagente distribuye la memoria. Cada agente tiene su propia memoria a corto plazo (el contexto actual), pero el sistema también debe mantener una memoria compartida de estado y de resultados pasados. Se trata de un reto arquitectónico específico.
La memoria a corto plazo es sencilla: es el contexto que el agente envía al LLM en cada invocación. Para un agente que utilice GPT-4 con una ventana de contexto de 128.000 tokens, se pueden almacenar los últimos 100 mensajes de una conversación. El problema: superado ese umbral, la información antigua se olvida. Un agente que gestiona un expediente complejo con 50 etapas puede perder de vista las decisiones tomadas al principio del proceso.
La memoria vectorial a largo plazo resuelve este problema. La información importante (decisiones, resultados clave, contexto de negocio) se codifica en vectores de embeddings y se almacena en una base de datos vectorial (Pinecone, Weaviate, Milvus). Cuando el agente necesita información, realiza una búsqueda por similitud semántica en su memoria vectorial. Es un enfoque difuso pero potente: el agente puede «recordar» años de historial sin que el contexto se desborde.
La memoria episódica registra las acciones pasadas de forma estructurada: qué tarea se ejecutó, cuándo, con qué resultados, qué errores se encontraron. Almacenada en una base de datos relacional o en grafo, permite a los agentes reconocer patrones repetitivos y aprender («hemos probado este enfoque 3 veces y ha fallado en todas ellas, probemos otra cosa»).
La memoria compartida entre agentes es fundamental en un sistema multiagente. Un estado compartido que cada agente puede consultar y modificar permite coordinar el trabajo sin redundancias. Pero también entraña un riesgo: si la memoria compartida contiene datos erróneos, todos los agentes situados aguas abajo quedan contaminados. La seguridad de la memoria compartida exige cifrado en reposo, control de acceso por agente (el agente A solo ve su parte de la memoria) y una retención limitada (purgar automáticamente los datos antiguos).
🔒 Seguridad de la memoria agéntica en producción
La memoria de un agente autónomo puede contener información altamente sensible: resultados de investigaciones de seguridad, datos de clientes, secretos técnicos. Estos datos deben protegerse como cualquier otro dato sensible de una organización.
El cifrado en reposo es obligatorio para los vector stores y las bases de memoria. Si un atacante compromete el servidor físico, los embeddings permanecen inutilizables sin la clave de descifrado. Los controles de acceso deben ser granulares: un agente del cliente X solo puede acceder a la memoria del cliente X. Los registros de acceso a la memoria (qué agente consultó qué registro) deben alimentar el SIEM para detectar accesos anómalos. Y deben definirse plazos de retención: transcurridos 90 días, los datos de memoria a largo plazo se purgan automáticamente, salvo que una necesidad legal o de negocio los justifique.
Es un detalle que se olvida fácilmente en los despliegues apresurados. Pero también es un vector de exposición de datos muy real: la memoria compartida de un sistema multiagente en producción suele contener más contexto sensible que el propio código de la aplicación.
⚙️ Frameworks y herramientas: construir en la práctica los sistemas multiagente
La teoría y la arquitectura están muy bien. Pero ¿cómo se programan estos sistemas en la práctica? El ecosistema de código abierto y comercial ofrece ahora varios frameworks que abstraen la complejidad de la orquestación.
CrewAI es el framework más accesible para un primer despliegue. Se define una «crew» (equipo) compuesta de agentes, cada uno con un rol, herramientas especializadas y objetivos. A continuación, se enumeran las tareas a realizar y el proceso (secuencial o jerárquico). CrewAI orquesta las llamadas al LLM, las transiciones entre agentes y la gestión del contexto. Su API es intuitiva, su documentación sólida y su curva de aprendizaje asequible para equipos sin experiencia profunda en IA.
LangGraph (LangChain) ofrece más control, pero exige más experiencia. Los flujos de trabajo se modelan como un grafo de estados: cada nodo es un agente o una función, y cada arista es una transición condicional. Se dispone de una capacidad de expresión superior para flujos de trabajo complejos con ramas y bucles. LangGraph también obliga a una mejor estructuración del código desde el principio. Es la opción indicada cuando los flujos de trabajo no encajan en los patrones estándar.
AutoGen (Microsoft Research) modela a los agentes como «participantes» en una conversación. Un agente usuario plantea una pregunta, un agente asistente responde, un agente ejecutor de código valida, etc. Es excelente para flujos de trabajo del tipo «pregunta → búsqueda → código → validación». Resulta menos adecuado para flujos de trabajo complejos con estado persistente.
En la práctica, para un equipo que empieza con los sistemas multiagente, el camino recomendado es: comenzar con CrewAI en un caso de uso sencillo (3 agentes como máximo, sin acciones irreversibles). Validar el enfoque, aprender de los errores. Avanzar hacia LangGraph si los casos de uso requieren más flexibilidad.
💻 Ejemplo concreto: un sistema multiagente para la seguridad informática
Tomemos un caso real: construir un sistema que clasifique las alertas de seguridad, las analice y genere informes para el equipo de CISO. Cuatro agentes colaboran entre sí.
El agente de triaje examina las alertas entrantes del SIEM, las clasifica por gravedad (crítica, alta, media, baja) y filtra los falsos positivos conocidos. Llama a APIs de threat intelligence (MISP, AlienVault) para enriquecer las alertas con el contexto de la amenaza.
El agente de investigación recibe las alertas críticas procedentes del triaje. Recopila los registros asociados (datos de red, procesos, archivos), los contrasta con el inventario de activos y elabora un informe de investigación inicial. Sus herramientas: acceso a los logs (Splunk), a la base de activos y a la threat intel.
El agente de contextualización enriquece la investigación con el contexto de negocio. ¿La dirección IP de origen corresponde a una filial conocida? ¿El usuario afectado está actualmente en teletrabajo? ¿Hay algún proyecto sensible en curso? Sus herramientas: APIs de negocio, directorio LDAP, calendario compartido.
El agente de informes sintetiza todo en un documento estructurado y listo para el CISO. Añade recomendaciones de acción basadas en los resultados y en las políticas de seguridad.
Esta cadena puede reducir el tiempo de triaje de 8 horas (con una sola persona) a 30 minutos. El humano permanece en el circuito para las decisiones críticas (aislamiento de la máquina, bloqueo de la cuenta), pero la investigación más pesada queda automatizada. Comprender los sistemas multiagente de IA permite desplegar exactamente este tipo de arquitectura en la empresa.
🚀 Despliegue y evolución: de la experimentación a la producción
Pasar de un prototipo a un sistema multiagente en producción exige una progresión cuidadosamente orquestada. Los equipos que intentan desplegar directamente en producción descubren rápidamente los límites de una arquitectura mal diseñada.
La fase 1 (sandbox): construir y probar en un entorno aislado. Sin acceso a datos reales sensibles, sin integración con sistemas de producción, con un plazo de unas pocas semanas. El objetivo: validar que la arquitectura multiagente responde a la necesidad del negocio y que los patrones de comunicación funcionan como se espera.
La fase 2 (staging limitado): integración con sistemas reales en modo de solo lectura. Los agentes pueden consultar los datos de producción pero no modificarlos. Se prueba la recuperación real de datos, el rendimiento con un volumen real y la calidad de los outputs. Duración: 4-8 semanas. Es en esta fase donde se descubren las incoherencias reales (la base de datos de producción tiene un esquema ligeramente distinto, las APIs presentan límites de tasa inesperados).
La fase 3 (producción limitada): despliegue en vivo sobre un subconjunto de casos. Un solo equipo prueba el sistema en su trabajo real. Todas las acciones críticas pasan por human-in-the-loop, sin acciones autónomas irreversibles. Monitorización estrecha de los comportamientos anómalos. Duración: 4-12 semanas según la complejidad. Es la escuela de la vida: aquí es donde se encuentran los casos extremos reales y se afinan los guardrails.
La fase 4 (producción progresiva): despliegue por etapas a lo largo de toda la organización, con un aumento progresivo de la autonomía. Primera oleada: solo lectura. Segunda oleada: acciones reversibles. Tercera oleada: acciones semirreversibles. Cuarta oleada: acciones críticas con HITL. Duración: varios meses. Es un proceso de aprendizaje continuo.
📈 Métricas y monitorización en producción
Medir el rendimiento de un sistema multiagente en producción es más complejo que simplemente contar las tareas completadas con éxito. Importan varias dimensiones.
A nivel del flujo de trabajo global: tasa de finalización (cuántos flujos llegan a su término sin escalado), tiempo de finalización (mediana y P99, no la media, que puede resultar engañosa), coste por ejecución (suma de las llamadas al LLM y de los recursos consumidos), y tasa de escalado humano (cuántas tareas han requerido una intervención manual).
A nivel de cada agente: precisión de los outputs (¿son correctos los resultados según una evaluación por muestreo aleatorio?), ratio de llamadas a herramientas frente a progreso (¿utiliza el agente sus herramientas de forma eficiente o pierde tiempo en llamadas innecesarias?) y latencia de generación.
A nivel de la calidad global: detección de alucinaciones en los outputs finales (mediante evaluación LLM-as-a-judge o validación humana), satisfacción de los usuarios finales con los outputs (feedback cualitativo recogido) y deriva temporal (¿se degrada el rendimiento con el tiempo, lo que indicaría una deriva de los datos de entrenamiento o cambios en el entorno?).
Es gracias a estas métricas que se detectan las oportunidades de mejora. Si la tasa de escalado es elevada, suele deberse a que un agente genera outputs fuera de los límites establecidos. Si el tiempo de finalización aumenta, puede que un agente esté utilizando sus herramientas de forma ineficiente. Las herramientas de tracing (LangSmith para LangChain) permiten inspeccionar cada llamada al LLM y cada decisión de los agentes para comprender dónde van mal las cosas.
La diferencia entre un sistema multiagente exitoso y uno que fracasa reside a menudo en el rigor de la monitorización y en la voluntad de optimizar de forma continua. Por bonita que sea la arquitectura sobre el papel, es la puesta en producción rigurosa la que determina el éxito.
🌐 Interoperabilidad y evolución: hacer que los sistemas sean flexibles y mantenibles
Un sistema multiagente construido hoy debe poder evolucionar. Surgen nuevos LLM, las herramientas disponibles cambian, las necesidades del negocio se transforman. La arquitectura debe absorber estos cambios sin necesidad de una reconstrucción completa.
La interoperabilidad significa que los agentes pueden funcionar con distintos LLM subyacentes. Un agente no debe quedar fuertemente acoplado al modelo GPT-4 de forma irreversible. Las abstracciones de framework (LangChain) permiten cambiar de LLM modificando simplemente una configuración, sin tocar la lógica del agente. Esto resulta crítico para adaptarse a la rápida evolución del mercado de la IA.
La reutilización de las herramientas también mejora la mantenibilidad. En lugar de que cada agente implemente sus propias integraciones con las APIs, las herramientas se definen una sola vez y se comparten. Un agente utiliza la herramienta «búsqueda web» sin saber (ni preocuparse) si pasa por Google Custom Search, Bing o DuckDuckGo. Cambiar la implementación de la herramienta no exige reescribir los agentes.
La separación entre el dominio de negocio y la infraestructura facilita la colaboración entre equipos. Los desarrolladores definen la lógica de negocio (qué agentes, qué tareas, qué proceso), mientras que el equipo de infraestructura/operaciones gestiona el despliegue, la escalabilidad y la supervisión. Cuando estas capas están bien separadas, los cambios de negocio no exigen recompilar la infraestructura.
Un sistema multiagente maduro combina estos tres elementos: abstracciones de framework sólidas, reutilización de las herramientas y una separación clara de las responsabilidades. Son los cimientos para una evolución sostenible a largo plazo.
🎯 Las consideraciones éticas y de gobernanza de los sistemas autónomos
Otorgar autonomía a los agentes de IA para tomar decisiones operativas plantea preguntas éticas legítimas. ¿Quién es responsable si un agente comete un error? ¿Cómo garantizar que las decisiones sean justas y no reproduzcan sesgos? ¿Qué nivel de transparencia ofrecer a los usuarios finales afectados?
La responsabilidad no puede transferirse por completo a la máquina. La organización sigue siendo responsable de las decisiones de sus agentes autónomos. Esto significa que los guardrails y el human-in-the-loop no son opcionales para las decisiones sensibles: son obligaciones legales y éticas. Un agente que rechaza una solicitud de préstamo debe poder ser cuestionado, y su decisión debe poder explicarse.
La transparencia: los usuarios afectados por las decisiones de un sistema autónomo deben poder entender por qué se han tomado. Un candidato rechazado por un agente de contratación debe poder pedir explicaciones. Esto impone restricciones de diseño: los agentes no solo deben tomar una decisión, sino también explicar su razonamiento de forma accesible (no «el transformer ha generado un logit de 0,723 para la clase rechazo»).
La no discriminación: los sistemas multiagente heredan los sesgos de los datos de entrenamiento y de los datos operativos. Si un agente decisor se entrena con datos que contienen discriminación histórica, la reproducirá y la amplificará. La auditoría periódica de las decisiones por categorías demográficas (género, origen, etc.) resulta obligatoria para detectar desviaciones discriminatorias.
Estas consideraciones no deben añadirse a posteriori. Deben integrarse en el diseño desde el principio: evaluación de impacto antes del despliegue, human-in-the-loop para las decisiones sensibles, auditoría periódica y derecho a la explicación para los usuarios afectados.
Author Profile
Latest entries
 Planeta15 November 2026Emisiones de CO2: por qué el transporte sigue siendo el punto negro del clima en Francia
 Inteligencia Artificial12 November 2026Imagine Enterprise: IBM y Microsoft unen sus agentes de IA para las grandes empresas
 Economía11 November 2026Tipo del Livret A: cómo se calcula y cuáles son sus límites
 Compras8 November 2026Black Friday: las fechas clave y el presupuesto previsto por los franceses
Este artículo ha sido redactado con la ayuda de una inteligencia artificial. Política editorial