🎯 Kurz gesagt: Multi-Agenten-Systeme stellen die natürliche Weiterentwicklung der generativen künstlichen Intelligenz dar und ermöglichen es, mehrere spezialisierte Agenten zu orchestrieren, um komplexe Geschäftsprozesse zu automatisieren. Im Gegensatz zu einem einzigen monolithischen Agenten verteilt diese dezentrale Architektur die kognitiven Aufgaben auf autonome, aber koordinierte Einheiten, von denen jede ein bestimmtes Themengebiet beherrscht. Dieser Ansatz löst die Grenzen klassischer LLMs: Kontextverlust, Halluzinationen und die Unfähigkeit, mehrstufige Workflows zu bewältigen. Im Zentrum dieser Transformation steht die intelligente Orchestrierung, bei der jeder Agent nach standardisierten Protokollen kommuniziert (insbesondere dem Model Context Protocol) und so eine zuverlässige, nachvollziehbare und gesteuerte Ausführung gewährleistet. Die betrieblichen Vorteile zeigen sich sofort: weniger menschlicher Zeitaufwand, bessere Ergebnisqualität und kontrollierte Risiken durch integrierte Überwachung.
💡 Die wichtigsten Punkte: Ein KI-Agent handelt in kritischen Umgebungen niemals allein; die Multi-Agenten-Architektur ermöglicht eine intelligente Zusammenarbeit, bei der jede Komponente spezialisiert und beherrschbar bleibt. Die Orchestrierung bestimmt 80 % der Gesamtleistung – wichtiger als die Leistungsfähigkeit des Modells selbst. Das MCP (Model Context Protocol) standardisiert die Verbindungen zwischen Agenten und Geschäftstools und ebnet so den Weg für interoperable Ökosysteme. Qualitativ hochwertige Daten sind die absolute Grundlage: Kein Agent kann auf Basis fehlerhafter Informationen richtig entscheiden. Die menschliche Aufsicht bleibt für Entscheidungen mit hoher Tragweite unverzichtbar, selbst in „autonomen“ Systemen. Anwendungsfälle mit hohem ROI finden sich in wiederkehrenden, mehrstufigen Prozessen mit klar definiertem Geschäftskontext.
🚀 Warum ein einziger KI-Agent nicht mehr ausreicht, um die Komplexität im Unternehmen zu orchestrieren
Inhalt
Die Geschichte der generativen KI in Unternehmen folgt einem vorhersehbaren Verlauf. Die Teams beginnen mit einem einfachen Prompt: eine Frage an ein LLM senden und eine Antwort erhalten. Dann gehen sie zu RAG (Retrieval-Augmented Generation) über, das dem Modell erlaubt, interne Dokumente zu lesen. Danach kommt der einzelne Agent, der in der Lage ist, eine isolierte Aktion auszulösen. Doch bereits 2025–2026 stößt dieses Modell an seine Grenzen – und die IT-Leiter erfahren das auf die harte Tour.
Stellen Sie sich folgendes konkretes Szenario vor: Eine Bank beauftragt einen einzelnen Agenten damit, die Kreditdaten eines Kunden zu analysieren, dessen Historie zu prüfen, die aktuellen Wechselkurse abzufragen, die internen Risikoschwellen zu berücksichtigen, einen zusammenfassenden Bericht zu erstellen und eine Benachrichtigung an den zuständigen Kundenberater zu senden. Theoretisch sollte ein leistungsstarkes LLM das schaffen. In der Praxis? Der Agent verliert bereits beim vierten Schritt den Kontext, verwechselt die Risikoschwellen, vergisst den Namen des Kunden oder produziert abstruse Zahlen. Der Grund dafür ist nicht fehlende Intelligenz, sondern fehlende Spezialisierung und Governance.
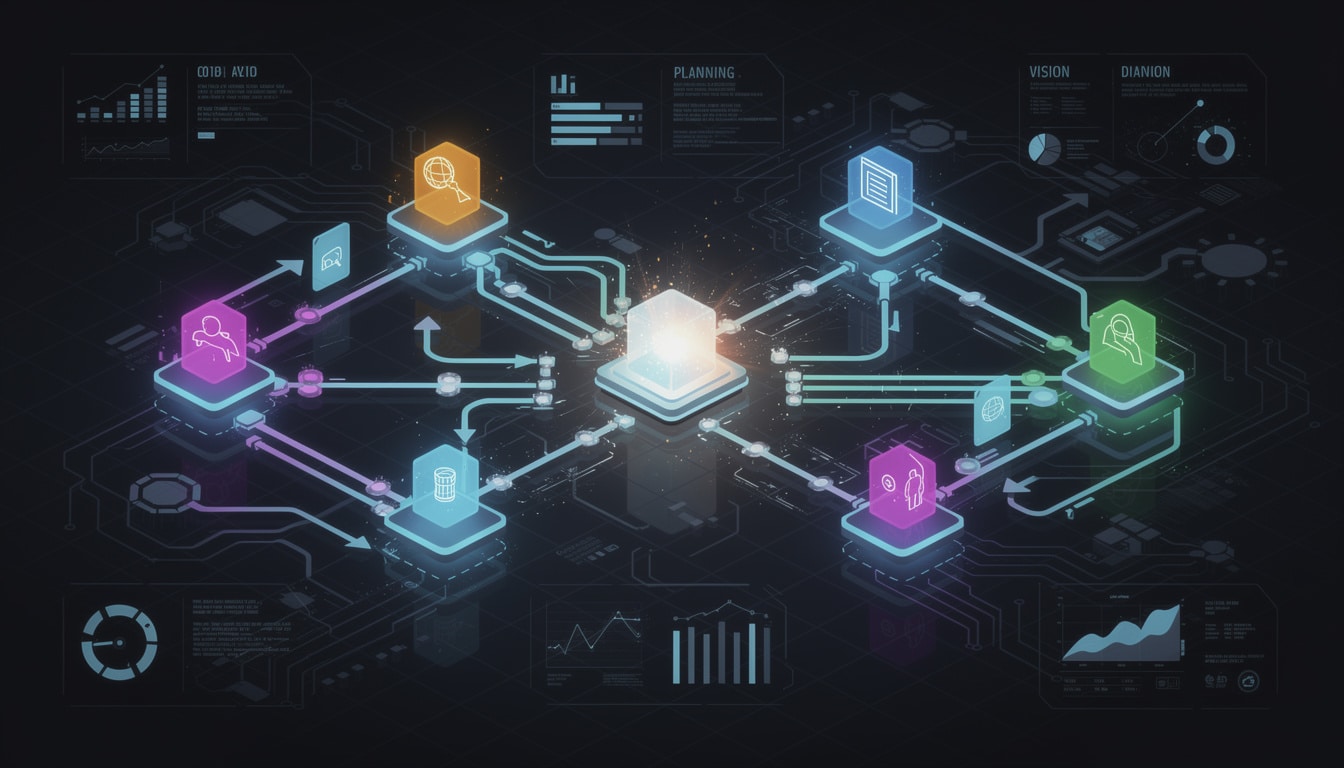
Ein einzelner Agent ist ein Alleskönner, der alles gleichzeitig jonglieren muss. Ein Multi-Agenten-System ist ein Team. Und es ist die organisatorische Struktur – nicht die reine Rechenleistung des Modells –, die generische KI in eine zuverlässige Automatisierung verwandelt. Genau deshalb werden Multi-Agenten-Architekturen zum Standard für die Orchestrierung komplexer Workflows: Sie spiegeln wider, wie Menschen schwierige Probleme auf natürliche Weise lösen.
🔍 Die Grenzen des monolithischen Modells zeigen sich im produktiven Einsatz
Wenn ein Unternehmen einen einzelnen Agenten für einen realen Geschäftsprozess einsetzt, treten systematisch drei Probleme auf. Das erste ist der Kontextverlust: Je mehr Denkschritte der Agent anhäuft, desto mehr verdünnt sich seine Aufmerksamkeit. Er startet stark, vergisst aber nach der fünften Aktion die ursprünglichen Vorgaben oder verwechselt Prioritäten. Das ist ein neuronales Problem, kein Softwarefehler.
Das zweite Problem ist die schwierige Iteration. Macht der Agent in Schritt 3 einen Fehler, ist alles Nachfolgende gefährdet. Eine Korrektur ist nur durch einen Neustart der gesamten Kette möglich. Mit mehreren spezialisierten Agenten kann jeder einzeln verbessert, getestet und bereitgestellt werden – das ist der Clou der Modularität.
Das dritte Problem ist die mangelnde Nachvollziehbarkeit. Führt die Entscheidung eines einzelnen Agenten zu einem problematischen Ergebnis, lässt sich die Argumentation kaum nachvollziehen, um zu verstehen, warum. Die Ausführungsprotokolle werden unlesbar. Bei einer gut durchdachten Multi-Agenten-Architektur wird jeder Schritt, jeder Tool-Aufruf, jede Entscheidung präzise protokolliert – ein entscheidender Faktor für die regulatorische Compliance und die kontinuierliche Verbesserung.
🏗️ Die grundlegenden Bausteine einer leistungsfähigen Multi-Agenten-Architektur
Ein Multi-Agenten-System zu bauen bedeutet nicht einfach, mehr Agenten hinzuzufügen. Es geht vor allem darum, die sechs wesentlichen Bausteine zu verstehen, die sie funktionieren lassen. Jeder dieser Bausteine spielt eine eigene Rolle, und ihr harmonisches Zusammenspiel entscheidet über Erfolg oder Scheitern des Systems. Einen davon zu ignorieren kommt einem Bauen auf Sand gleich.
Der erste Baustein ist die Denk-Engine – in der Regel ein LLM oder ein Hybridmodell –, die als „Gehirn“ jedes Agenten fungiert. Sie interpretiert Anweisungen, analysiert Daten und erzeugt eine Argumentation. Aber Achtung: Sie entscheidet nicht über das übergeordnete Ziel. Ihre Rolle ist strikt auf ihren Fachbereich begrenzt.
Der zweite Baustein besteht aus Tools und Erweiterungen. Ein Agent muss über APIs, Konnektoren und Geschäftsfunktionen auf die reale Welt einwirken können. Hier spielt das Model Context Protocol (MCP) eine zentrale Rolle: Es standardisiert, wie Agenten auf Tools zugreifen, und sorgt so für eine sichere und skalierbare Integration. Mit dem MCP bietet jedes Tool eine einheitliche Schnittstelle – unabhängig davon, ob es sich um eine Datenbank, einen Webdienst oder eine individuelle Funktion handelt.
Der dritte Baustein ist das strukturierte Gedächtnis – sowohl das Kurzzeitgedächtnis (der unmittelbare Kontext) als auch das Langzeitgedächtnis (die gesammelten Erfahrungen). Ohne Gedächtnis beginnt der Agent bei jeder Interaktion wieder bei null. Mit einem gut konzipierten Gedächtnis passt er sein Verhalten an und lernt aus vergangenen Fehlern.
Der vierte Baustein ist das Aktionsmodul – der Ausführer, der die Argumentation in konkrete Ergebnisse umsetzt. In einem Multi-Agenten-System übernimmt dieses Modul auch die Koordination: die Weitergabe von Aufgaben zwischen Agenten, die Zusammenführung von Ergebnissen und das Management von Abhängigkeiten.
Der fünfte Baustein ist der Orchestrator bzw. der Supervisor-Agent. Er ist der „Dirigent“, der die Gesamtanfrage entgegennimmt, sie in Teilaufgaben zerlegt, jede Aufgabe dem am besten geeigneten Agenten zuweist und die Ergebnisse zusammenführt. Der Orchestrator führt die Aufgaben nicht selbst aus; er delegiert intelligent und überwacht.
Der sechste und letzte Baustein ist die Kommunikationsschnittstelle – der Kanal, über den das System mit menschlichen Nutzern, anderen Agenten oder externen Systemen interagiert. Hier entsteht die Nutzererfahrung, aber hier zeigen sich auch Sicherheits- und Authentifizierungsprobleme.
Richtig zusammengesetzt, ergeben diese sechs Bausteine eine robuste Architektur, die komplexe Geschäftsworkflows mit einer Zuverlässigkeit bewältigen kann, die kein einzelner Agent erreichen könnte. Doch ihr bloßes Vorhandensein reicht nicht aus: Den entscheidenden Unterschied macht ihre koordinierte Orchestrierung.
⚙️ Orchestrierungsmuster: sequenziell, hierarchisch und kollaborativ
Wie lässt man mehrere Agenten miteinander kommunizieren, ohne dass sie sich in Endlosschleifen verfangen oder völlig vom Ziel abweichen? Das ist die Kernfrage der Orchestrierung. Die Antworten zeigen sich in drei unterschiedlichen Mustern, die jeweils für andere Geschäftskontexte geeignet sind.
🔗 Das sequenzielle Modell: ein kognitives Fließband
Bei diesem Muster arbeiten die Agenten seriell, wie an einem industriellen Fließband. Agent A extrahiert eine Information, gibt sie an Agent B weiter, der sie zusammenfasst, und übergibt sie an Agent C, der daraus einen Bericht erstellt. Der Ablauf ist deterministisch, kontrollierbar und leicht zu debuggen. Scheitert ein Schritt, weiß man genau, wo das Problem zu suchen ist.
Dieses Modell eignet sich hervorragend für gut normierte Verwaltungsprozesse. Ein Beispiel ist das Onboarding eines neuen Bankkunden: Agent 1 prüft die Dokumente, Agent 2 kontrolliert die Vorgeschichte, Agent 3 legt die Systemkonten an, Agent 4 versendet die Zugangsdaten. Keine Ermessensentscheidung, nur eine logische Abfolge von Schritten.
Die Gefahr des sequenziellen Modells zeigt sich, wenn Situationen Flexibilität erfordern. Erkennt Agent 2 eine unerwartete Anomalie, bietet der lineare Ablauf keinen Mechanismus, um auf einen alternativen Pfad umzuschwenken. Er läuft blind weiter oder bricht vollständig ab.
📊 Das hierarchische Modell: Supervisor und spezialisierte Ausführende
Hier hält ein Supervisor-Agent die Entscheidungshoheit. Er nimmt die komplexe Anfrage entgegen, analysiert die „Flotte“ der verfügbaren Agenten (einen Web-Scraping-Agenten, einen SQL-Agenten, einen Rechen-Agenten) und delegiert dynamisch je nach Kontext. Der Supervisor führt die Teilergebnisse zusammen und formuliert die endgültige Antwort.
Dieses Muster ist bei Unvorhersehbarkeit deutlich robuster. Stellt ein Nutzer eine vielschichtige Frage, die Finanzen, Wetter und Logistik vermischt, zerlegt der Supervisor die Anfrage gedanklich, ruft den Finanz-Agenten auf, dann den Wetter-Agenten, dann den Logistik-Agenten, und fasst die drei Antworten zu einer stimmigen Analyse zusammen. Genau das setzen moderne agentenbasierte Architekturen im Kern autonomer Systeme um.
Der Preis dafür ist die Komplexität: Der Supervisor muss intelligent und gut instrumentiert sein, um richtig zu delegieren. Schlecht konfiguriert, wird er zum Flaschenhals, der das gesamte System ausbremst.
💬 Das kollaborative Modell: Debatte und kollektive Emergenz
Dieses ambitioniertere und schwieriger zu beherrschende Muster versetzt mehrere Agenten in einen virtuellen Diskussionsraum, in dem sie debattieren. Ein Agent „Finanzieller Konservativer“ diskutiert mit einem Agenten „Aggressives Wachstum“ über einen Investitionsplan. Ihre gegensätzlichen Sichtweisen erzeugen eine Risikoanalyse von einer Tiefe, die kein einzelner Agent allein hervorbringen könnte.
Dieses Modell erzeugt eine emergente Intelligenz, allerdings um den Preis der Unvorhersehbarkeit. Die Agenten können in ihren Meinungen abweichen, sich in ihren Positionen festfahren oder zu einer verzerrten Schlussfolgerung kommen, wenn die Debatte nicht gut gesteuert wird. Deshalb braucht man einen Schlichter – oft einen Menschen –, der beide Standpunkte anhört und entscheidet.
Das kollaborative Muster glänzt besonders in Erkundungs- und Innovationsphasen: Brainstorming aus mehreren Perspektiven, Bewertung komplexer Szenarien oder bereichsübergreifende Diagnosen. Für operative Prozesse, die eine schnelle und vorhersehbare Ausführung erfordern, ist es jedoch ungeeignet.
🛠️ Ein effizientes Multi-Agenten-System entwerfen: die wichtigsten Schritte
Der Weg vom Konzept in die Produktion erfordert ein strukturiertes Vorgehen. Wer improvisiert, riskiert fragile, teure und unzuverlässige Deployments. So gehen erfolgreiche Organisationen vor.
🎯 Schritt 1: Den Geschäftsbedarf eingrenzen und Anwendungsfälle identifizieren
Alles beginnt mit einer unbequemen Frage: Was ist eigentlich das Problem? Viele Organisationen verwechseln „einen KI-Agenten zu haben“ mit „ein Geschäftsproblem zu lösen“. Tatsächlich zielen die besten Multi-Agenten-Anwendungsfälle auf wiederkehrende, zeitaufwendige Tätigkeiten mit geringem Ausgangsrisiko, aber hohem potenziellem ROI. Ein Versicherungsunternehmen könnte ein Multi-Agenten-System nutzen, um kleinere Schadensfälle automatisch zu bearbeiten und so die Mitarbeiter für komplexe Fälle freizustellen, die menschliches Urteilsvermögen erfordern.
Die Eingrenzung umfasst auch das Ziehen von Grenzen: Welche Entscheidungen müssen unter menschlicher Aufsicht bleiben? Welches Maß an Autonomie ist akzeptabel? Das Sammeln von Informationen kann zu 100 % autonom erfolgen, eine Geldüberweisung erfordert jedoch stets eine menschliche Genehmigung. Ohne diese klaren Grenzen bauen Sie ein System, das Ihnen aus den Händen gleitet.
🔧 Schritt 2: Den technischen Stack und die Modelle auswählen
Die Wahl des LLM, des Orchestrierungs-Frameworks und der Integrationstools hängt vollständig vom jeweiligen Kontext ab. Haben Sie Agenten, die auf natürliche Sprache spezialisiert sind? Wählen Sie ein leistungsstarkes Allzweckmodell wie GPT-4 oder Claude. Benötigen Sie Geschwindigkeit und Kosteneffizienz? Ziehen Sie Small Language Models (SLM) in Betracht, die auf Ihre Geschäftsdaten feinjustiert wurden. Haben Sie Anforderungen an digitale Souveränität? Prüfen Sie Open-Source-Modelle wie Llama oder Mistral.
Für die Orchestrierung bieten moderne Frameworks wie LangGraph, CrewAI oder AutoGen jeweils unterschiedliche Stärken. LangGraph überzeugt durch seine Flexibilität, CrewAI durch seine didaktische Einfachheit, AutoGen durch seine Robustheit im Multi-Agenten-Betrieb. Die Wahl hängt von Ihrem Team und Ihren Kontrollanforderungen ab.
Eine Einstiegsarchitektur setzt häufig auf Einfachheit: ein zentraler (hierarchischer) Orchestrator mit 3 bis 5 spezialisierten Agenten, integriert über klare und gut dokumentierte APIs. Dieser Ansatz ist vorhersehbar und skalierbar.
🔌 Schritt 3: Die Agenten implementieren und verbinden
Hier beginnt die eigentliche Komplexität. Jeder Agent muss erstellt werden (Rolle, Verantwortlichkeiten und Beschränkungen definieren), seine Tools müssen über das MCP oder proprietäre Konnektoren angebunden werden, Ein- und Ausgabedaten müssen strukturiert werden, und die Aufrufe zwischen den Agenten müssen orchestriert werden. Jede Verbindung ist ein potenzieller Reibungspunkt: falsch formatierte Daten, Netzwerk-Timeouts, fehlerhafte Authentifizierungen.
Eine gute Praxis ist es, klein anzufangen: ein einziger durchgängiger End-to-End-Workflow, selbst wenn nur zwei Agenten beteiligt sind. Sobald dieses Fundament stabil steht, können Sie weitere Agenten hinzufügen und die Orchestrierung komplexer gestalten.
🧪 Schritt 4: Ständig testen, beobachten und iterieren
Ein produktives Multi-Agenten-System muss kontinuierlich beobachtet werden. Welche Agenten werden am häufigsten aufgerufen? Wo konzentrieren sich die Fehler? Wie lange dauert die durchschnittliche Bearbeitung eines Workflows? Observability-Dashboards sind kein Luxus, sondern eine betriebliche Notwendigkeit.
Die Tests müssen mehrere Ebenen abdecken: Unit-Tests für jeden einzelnen Agenten, Integrationstests für den gesamten Ablauf, Lasttests, um zu prüfen, dass das System unter Traffic nicht zusammenbricht. Die heimtückischsten Fehler zeigen sich oft erst unter Belastung – ein Agent kann bei 10 Anfragen pro Minute perfekt funktionieren, aber bei 100 Anfragen pro Minute aus dem Takt geraten.
Die Iterationen müssen schnell und strukturiert erfolgen. Eine Woche Beobachtung, eine Aktualisierung der Prompts oder der Routing-Logik, dann wieder eine Woche Test. So verbessert man schrittweise Zuverlässigkeit und Leistung.
📈 Schritt 5: Leistung und Kosteneffizienz optimieren
Sobald das System stabil läuft, rückt die Optimierung in den Fokus. Agenten, die miteinander kommunizieren, verbrauchen Tokens. Eine ineffiziente Orchestrierung kann schnell zu exponentiell steigenden Rechnungen führen. Deshalb müssen die Kosten erfasst werden: Wie viel kostet jeder Agent im Durchschnitt? Welcher Agent liefert den besten ROI? Gibt es unnötige Schleifen, die beseitigt werden können?
Optimierung bedeutet auch die richtige Modellwahl. Oft lässt sich ein teurer Schritt (ein GPT-4-Aufruf) durch eine einfache logische Regel oder ein leichteres Modell ersetzen. Das Geheimnis: für jede Aufgabe das beste Werkzeug einsetzen, nicht überall das leistungsstärkste. Ein Agent, der eine Formulareingabe validiert, braucht kein GPT-4; ein kleines spezialisiertes Modell reicht aus und kostet zehnmal weniger.
📱 Konkreter Anwendungsfall: ein WhatsApp-Agent zur Terminorchestrierung
Schauen wir uns an, wie das in der Praxis funktioniert. Ein Dienstleistungs-Start-up möchte die Terminvereinbarung über WhatsApp automatisieren. Kunden senden ihre Verfügbarkeiten in natürlicher Sprache („Hallo, ich kann dienstags nachmittags oder donnerstags morgens“), und das System muss die Zeitfenster extrahieren, den Kalender prüfen, den Termin bestätigen und ihn im CRM speichern – alles ohne menschliches Eingreifen.
🔄 Der detaillierte Architekturablauf
Der Nutzer sendet eine WhatsApp-Nachricht über die WhatsApp Business API. Die Nachricht erreicht das Backend, das sie bereinigt (Entfernung sensibler Daten), Kontext ergänzt (Kundenprofil, Historie, Zeitzone) und sie an das Multi-Agenten-System weiterleitet. So orchestrieren sich die Agenten.
Agent 1: Intentions-Analyzer. Er empfängt die Rohnachricht und erkennt die geschäftliche Absicht. Handelt es sich um eine Terminanfrage? Eine Stornierung? Eine Verschiebung? Dank des LLM versteht er Formulierungen wie „dienstags nachmittags“ oder „am Ende des Tages“ und übersetzt sie in strukturierte Zeitfenster (Dienstag 14–18 Uhr). Ist die Absicht unklar, formuliert er eine Klärungsfrage und wendet sich erneut an den Nutzer. Dieser Agent ist hochspezialisiert: Verständnis natürlicher Sprache, nichts weiter.
Agent 2: Verfügbarkeitsprüfer. Er erhält die von Agent 1 extrahierten Zeitfenster und gleicht sie mit der Realität ab: Aufruf des MCP-Tools „Kalender“, um zu prüfen, welche Zeitfenster tatsächlich frei sind. Der Agent erfindet nichts, er befragt die verlässliche Quelle und erhält eine binäre Antwort: frei oder belegt. Lautet die Antwort „belegt“, bittet er Agent 1, Alternativen vorzuschlagen.
Agent 3: Bestätiger und Protokollierer. Sobald ein Zeitfenster bestätigt und vom Kunden akzeptiert wurde, erstellt dieser Agent den Termin im Kalender, sendet die Einladung und aktualisiert das CRM. Er sorgt auch für die Nachvollziehbarkeit: Jede Aktion wird mit Zeitstempel und Signatur protokolliert.
Zentraler Orchestrator. Er empfängt die ursprüngliche Nachricht, gibt sie an Agent 1 weiter, erhält die Zeitfenster, sendet sie an Agent 2, verwaltet die Verhandlungsschleife, falls bestimmte Zeitfenster belegt sind, und löst schließlich Agent 3 für die endgültige Bestätigung aus. Scheitert bei einem Schritt etwas, übernimmt der Orchestrator die Ausweichlösungen: „Das habe ich nicht verstanden, kannst du das anders formulieren?“ oder „Dieser Termin ist nicht mehr frei, versuchen wir etwas anderes“.
⚡ Vorteile für das Unternehmen
Das Start-up spart 20 bis 30 Stunden menschlicher Arbeit pro Woche: Es braucht keine eigene Person mehr, die Terminanfragen beantwortet. Kunden erhalten rund um die Uhr eine sofortige Bestätigung über WhatsApp, ohne auf einen Menschen warten zu müssen. Die Fehlerquote sinkt drastisch: keine Doppelbuchungen, keine falsch übertragenen Zeitfenster. Jede Interaktion wird protokolliert und lässt sich nutzen, um die Servicequalität kontinuierlich zu verbessern.
Und hier der entscheidende Punkt: Dieses System ist nur dank der Spezialisierung stabil. Jeder Agent tut genau eine Sache. Hätte man einen „Super-Agenten“ geschaffen, der natürliche Sprache versteht, den Kalender prüft, Termine erstellt und Ausnahmen behandelt, wäre dieser einzelne Agent schwer zu debuggen, teuer zu verbessern und im produktiven Betrieb wenig robust. Multi-Agenten-Architekturen machen das einfach.
🔐 Governance, Risiken und Aufsicht in der Multi-Agenten-Orchestrierung
Sobald autonome Agenten eingesetzt werden, die Entscheidungen treffen und Aktionen ausführen können, rückt die Technik in den Hintergrund. Was wirklich zählt, ist die Governance. Ohne klaren Rahmen werden selbst die besten Modelle gefährlich.
🛡️ Sicherheit und streng definierter Handlungsrahmen
Jeder Agent muss minimale Zugriffsrechte haben: Er darf nur auf die Daten und Tools zugreifen, die er für seine Aufgabe benötigt, nicht mehr. Ein Agent zur Auftragsbearbeitung braucht keinen Zugriff auf Personaldatenbanken. Ein Agent zur Finanzanalyse muss keine Nutzer anlegen können. Diese Grenzen sind keine willkürlichen Einschränkungen; sie sind Sicherheitsleitplanken.
Die Kommunikationsströme zwischen Agenten müssen verschlüsselt sein. Tool-Aufrufe müssen authentifiziert werden. Ausführungsprotokolle müssen unveränderlich sein. Diese Anforderungen verwandeln einen verspielten Prototyp schnell in ein produktionsreifes System.
👁️ Menschliche Aufsicht und Echtzeit-Dashboards
Selbst in einem System autonomer Agenten muss jemand bei einer Anomalie auf „Pause“ drücken können. Das erfordert Dashboards, die in Echtzeit den Status jedes Agenten, die Anzahl der Fehler, die getroffenen Entscheidungen und die verbrauchten Ressourcen anzeigen. Weicht ein Agent von seinen normalen Parametern ab, müssen sofort Warnmeldungen ausgelöst werden.
Bestimmte Entscheidungen – größere Geldtransfers, kritische Datenbankänderungen – müssen vor der Ausführung eine ausdrückliche menschliche Genehmigung erfordern. Das ist das „Human-in-the-Loop“-Modell, das Autonomie und Kontrolle ausbalanciert.
📝 Vollständige Erklärbarkeit und Nachvollziehbarkeit
Wenn ein KI-Agent eine Handlung empfiehlt oder eine Entscheidung trifft, müssen Sie die gesamte Argumentation nachvollziehen können, um das „Warum“ zu verstehen. Das bedeutet, Folgendes zu protokollieren: Welcher Prompt wurde an das Modell gesendet? Welche Tools wurden aufgerufen? Welche Daten wurden abgerufen? Was war das Ergebnis? Vollständige Transparenz ist keine bequeme Option, sondern eine regulatorische Anforderung im Gesundheitswesen, im Finanzsektor und in anderen regulierten Branchen.
Die Microsoft-Dokumentation zu Design-Patterns für KI-Agenten betont diesen Punkt ausdrücklich: Observability und Nachvollziehbarkeit sind ebenso kritisch wie die Funktionalität selbst.
⚙️ Kostenmanagement und Vermeidung von Endlosschleifen
Ein Agent, der unendlich mit einem anderen Agenten diskutiert oder wiederholt dasselbe Tool aufruft, kann Ihre Cloud-Rechnung innerhalb weniger Stunden explodieren lassen. Deshalb müssen Sicherungen (Circuit Breaker) implementiert werden: Begrenzen Sie die Anzahl der Iterationen, legen Sie Timeouts fest, setzen Sie Ausgabenobergrenzen pro Workflow. Werden diese Grenzen erreicht, brechen Sie sofort ab und alarmieren Sie einen Menschen.
Die Kosten zu erfassen ist ebenso wichtig wie die Latenz zu überwachen. Welcher Agent verbraucht die meisten Tokens? Welcher Workflow liefert den besten ROI? Diese Kennzahlen leiten Ihre Optimierungs- und Investitionsentscheidungen.
🚀 Die künftige Entwicklung: hin zu verteilten Agenten-Ökosystemen
Wir befinden uns an einem Wendepunkt der generativen KI. Monolithische LLMs werden nicht verschwinden, aber sie werden zu Komponenten innerhalb einer größeren Architektur: Multi-Agenten-Systeme, die in komplexen Umgebungen zusammenarbeiten, denken und handeln können. Was dabei entsteht, ist eine neue Ebene kollektiver Intelligenz.
🌐 Das Model Context Protocol: Standardisierung der Interoperabilität
Bis vor kurzem hatte jede KI-Plattform ihre eigenen Konventionen, um Agenten mit Tools zu verbinden. OpenAI verfolgte einen Ansatz, Anthropic einen anderen, Microsoft einen dritten. Diese Fragmentierung verlangsamte die Innovation und schuf technische Silos, die teuer zu pflegen waren.
Das Model Context Protocol (MCP) verändert die Spielregeln. Es bietet einen offenen, einheitlichen Standard für die Kommunikation zwischen Agent und Tool. Mit dem MCP kann jeder Anthropic-Agent mit einem auf Azure gehosteten Tool interagieren, das wiederum mit einer AWS-Lambda-Funktion kommunizieren kann. Interoperabilität wird real. Deshalb ist das MCP rasch zu einem zentralen Element moderner agentenbasierter Architekturen geworden – es ist die „gemeinsame Sprache“, die es Ökosystemen erlaubt zu wachsen.
🎨 Die Nutzeroberfläche direkt in den Agenten (MCP UI)
Eine bedeutende Entwicklung, die derzeit im Gange ist: Agenten werden schon bald nicht nur Text und Bilder zurückgeben, sondern auch interaktive Oberflächenelemente – Formulare, dynamische Tabellen, Diagramme, Aktionsschaltflächen. OpenAI integriert diese Fähigkeit bereits, und Shopify hat mit seinen Commerce-Tools den Weg bereitet. Stellen Sie sich vor: Ein Agent fordert eine Bestätigung für eine größere Zahlung an, und der Nutzer kann direkt mit einem eingebetteten Formular interagieren, ohne die Konversation zu verlassen.
Das steigert den Nutzen der Agenten erheblich, indem sie interaktiver, weniger textbasiert und visueller werden.
🧠 Hybride Architekturen und verteilte Intelligenz
Die Zukunft wird nicht monolithisch sein. Es entstehen Architekturen, die Folgendes kombinieren: generalistische LLMs für abstraktes Denken, spezialisierte SLMs für präzise Aufgaben, Vision-Modelle für visuelle Daten, Regel-Engines für deterministische Geschäftslogik. Jede Komponente spielt eine genaue Rolle in der Gesamtorchestrierung.
Diese Heterogenität erlaubt es, Leistung und Effizienz zu verbinden. GPT-4 wird nur dann eingesetzt, wenn es wirklich nötig ist; die restliche Zeit reichen leichtere und günstigere Modelle aus. Das ist ein deutlich pragmatischerer Ansatz als „das beste Modell für alles“.
📊 Durchgängige Automatisierung von Geschäftsprozessen
Multi-Agenten-Systeme werden zu virtuellen Mitarbeitern, die in Geschäftstools integriert sind: CRM, ERP, HR-Suiten, Kundensupport-Tools. Ein Agent kann ein Support-Ticket lesen, das Problem extrahieren, die Wissensdatenbank konsultieren, eine Lösung vorschlagen oder an einen Menschen eskalieren – alles transparent für den Endnutzer.
Der wahre Wert liegt nicht in der Technologie, sondern in der Reduzierung operativer Reibungsverluste. Weniger manuelle Schritte, weniger Kontextwechsel, weniger menschliche Fehler, mehr Zeit für wertschöpfende Aufgaben.
💡 Die wichtigsten Kennzahlen zur Erfolgsmessung eines Multi-Agenten-Systems
Ein Multi-Agenten-System bereitzustellen ist gut. Es richtig zu steuern ist besser. Ohne geeignete Kennzahlen navigieren Sie blind und treffen Entscheidungen auf Basis von Vermutungen, nicht von Fakten.
⏱️ Leistung und operative Zuverlässigkeit
Durchschnittliche Antwortzeit pro Workflow. Wie lange braucht der Orchestrator, um eine Anfrage vollständig zu bearbeiten? Wenn Sie 30 Sekunden anstreben und 3 Minuten erhalten, stimmt etwas nicht – ein langsamer Agent, ein blockierender Tool-Aufruf, ein Netzwerkproblem. Kontinuierliches Monitoring identifiziert den Flaschenhals.
Erfolgsquote (Success Rate). Welcher Prozentsatz der Workflows wird gleich beim ersten Versuch korrekt abgeschlossen? Eine Quote von 95 % bedeutet, dass 5 % der Anfragen eine Wiederholung oder menschliches Eingreifen benötigen. Das ist wahrscheinlich akzeptabel. Eine Quote von 70 % bedeutet, dass Ihr System nicht produktionsreif ist. Sie müssen die Agenten oder die Orchestrierung überarbeiten.
Fehlerquote pro Agent. Ermitteln Sie, welcher Agent am häufigsten Probleme verursacht. Wenn der Analyse-Agent in 15 % der Fälle scheitert, während der Bestätigungs-Agent nur in 1 % der Fälle scheitert, wissen Sie, wo Sie Ihre Verbesserungsmaßnahmen konzentrieren müssen.
💰 Wirtschaftliche Effizienz und ROI
Kosten pro Transaktion. Wie viel kostet eine bearbeitete Anfrage im Durchschnitt? (verbrauchte Tokens, Infrastruktur, Wartung). Teilen Sie diese Kosten durch die eingesparte menschliche Arbeitszeit, und Sie erhalten den ROI. Wenn ein Agent 2 Stunden menschlicher Arbeit für 10 Dollar Infrastrukturkosten einspart, ist das eine rentable Investition.
Modellnutzung. Welcher Prozentsatz der Transaktionen nutzt GPT-4 (teuer) im Vergleich zu SLM (günstig)? Je mehr Sie an leichtere Modelle delegieren, desto mehr optimieren Sie die Kosten, ohne die Qualität zu beeinträchtigen.
🎯 Geschäftliche Zufriedenheit und operative Wirkung
Akzeptanzrate bei den Nutzern. Wenn die Fachabteilungen das System für 20 % ihrer Zielaufgaben nutzen, ist das ein Erfolg. Bei 80 % ist es ein durchschlagender Erfolg. Bei 5 % gibt es ein Vertrauens- oder UX-Problem zu lösen.
Reduzierung der Durchlaufzeit. Messen Sie die Aufgaben vor und nach der Implementierung. Ein Prozess, der 4 Stunden dauerte und jetzt nur noch 30 Minuten benötigt, hat 3,5 Stunden menschliche Produktivität pro Transaktion freigesetzt. Multiplizieren Sie das mit dem Jahresvolumen, und Sie sehen die wahre Wirkung.
📋 Compliance und Governance
Abdeckung des Audit-Trails. Werden 100 % der Agenten-Entscheidungen protokolliert und sind nachvollziehbar? Lautet die Antwort „Nein“, besteht ein erhebliches Compliance-Risiko. Lautet sie „Ja“, können Sie kontinuierlich auditieren und verbessern.
Governance-Verstöße. Wie oft hat ein Agent versucht, auf Ressourcen außerhalb seines zugelassenen Bereichs zuzugreifen? Selbst ein einziger Vorfall ist ein Problem, das umgehend behoben werden muss.
🎓 Kontinuierliches Lernen und iterative Verbesserung
Ein in der Produktion eingesetztes Multi-Agenten-System ist niemals „fertig“. Es ist ein lebender Organismus, der sich kontinuierlich an geschäftliche Veränderungen, entdeckte Fehler und KI-Innovationen anpassen muss.
📈 Feedback-Schleifen und Prompt-Anpassung
Analysieren Sie jede Woche die fehlgeschlagenen Workflows. Warum hat sich der Agent geirrt? War es ein Problem beim Verständnis natürlicher Sprache (unzureichender Prompt) oder ein Problem beim Datenzugriff (fehlerhaftes Tool)? Die schnellsten Verbesserungen entstehen oft durch eine Feinabstimmung des Prompts – mehr Kontext hinzufügen, Anweisungen präzisieren, Einschränkungen genauer formulieren.
Aber Vorsicht: Die Anpassungen müssen vor der Bereitstellung gründlich getestet werden. Eine Prompt-Änderung, die 90 % der Fälle verbessert, kann 10 % davon kaputt machen. Deshalb sind automatisierte A/B-Tests über Tausende von Fällen unerlässlich.
🔄 Versionierung und kontrolliertes Rollback
Versionieren Sie jede Komponente des Systems: Version des LLM-Modells, Version des Prompts, Version der Orchestrierungslogik. Wenn ein Update die Leistung verschlechtert, können Sie innerhalb von Minuten zur vorherigen Version zurückkehren – nicht erst nach Tagen.
Das erfordert eine ausgereifte Deployment-Infrastruktur: CI/CD-Pipelines, automatisierte Tests bei jedem Commit, Canary-Deployments für einen kleinen Prozentsatz der Nutzer vor dem vollständigen Rollout. Das ist kein Luxus, sondern professionelle Sorgfaltspflicht.
🚀 Horizontale Skalierbarkeit und Hinzufügen neuer Agenten
Während sich Ihr Anwendungsfall weiterentwickelt, werden Sie wahrscheinlich neue Agenten hinzufügen, um zusätzliche Bereiche abzudecken. Die Architektur muss dieses Wachstum ohne größere Umbauten ermöglichen. Das bedeutet eine klare und stabile Orchestrierungs-Schnittstelle, ein erweiterbares Routing-System und eine Infrastruktur, die mehr parallele Aufrufe verarbeiten kann.
Eine gute Multi-Agenten-Architektur wächst von 3 auf 30 Agenten, ohne dass sich das Konzept grundlegend ändert. Eine schlechte Architektur bricht bereits ab 5 Agenten zusammen.
🌟 Jenseits des Hypes: Wann sich ein Multi-Agenten-System wirklich lohnt
Nicht jedes Problem rechtfertigt eine Multi-Agenten-Architektur. Zu wissen, wann man sie einsetzt und wann man es einfach hält, ist eine entscheidende Fähigkeit.
✅ Die Anzeichen dafür, dass Sie Multi-Agenten brauchen
Der Workflow umfasst 4 oder mehr eigenständige Schritte. Ist Ihr Prozess wirklich linear (Daten abrufen → berechnen → Ergebnis zurückgeben), reicht ein einzelner Agent aus. Doch sobald Verzweigungen, Schleifen oder Querprüfungen nötig sind, wird Multi-Agenten sinnvoll.
Mehrere Fachbereiche sind beteiligt. Ein Workflow, der Finanzen, HR und Logistik vermischt, erfordert wahrscheinlich drei spezialisierte, zusammenarbeitende Agenten statt eines verwirrten Allrounder-Agenten.
Das Volumen ist erheblich. Wenn Sie 100 Anfragen pro Tag bearbeiten, rechtfertigen die Zuverlässigkeits- und Wartbarkeitsgewinne den Mehraufwand der Multi-Agenten-Orchestrierung. Bei 10 Anfragen pro Monat ist das übertrieben.
Die Nachvollziehbarkeit ist entscheidend. In Finanzen, Gesundheitswesen oder Compliance müssen Sie jede Entscheidung auditieren können. Multi-Agenten bietet diese Granularität ganz natürlich.
❌ Wann es einfach bleiben sollte
Ein einstufiger Workflow oder zwei stark voneinander abhängige Schritte. „Der Nutzer stellt eine Frage, das Modell antwortet.“ Multi-Agenten ist hier nicht nötig. Der einzelne Agent funktioniert einwandfrei und ist deutlich leichter zu pflegen.
Sehr geringes Volumen oder Ad-hoc-Nutzung. Wenn ein Tool von Menschen selten oder unvorhersehbar genutzt wird, fügt Multi-Agenten eine Komplexität hinzu, die nicht durch einen Effizienzgewinn ausgeglichen wird.
Hochdynamischer und unvorhersehbarer Kontext. Wenn jede Anfrage eine völlig neue logische Herangehensweise erfordert (keine wiederholbaren Muster), verlieren mehrfach spezialisierte Agenten ihren Vorteil. Die Anpassungsfähigkeit eines generalistischen LLM wird dann wertvoller.
📚 Praktische Ressourcen und Werkzeuge für den Einstieg
Wenn Sie überzeugt sind, dass Multi-Agenten der richtige Ansatz ist, finden Sie hier die Ressourcen, um ins Handeln zu kommen.
Für die konzeptionelle Gestaltung bietet der LinkedIn-Artikel über die Gestaltung effizienter Multi-Agenten-Systeme eine ausgezeichnete Zusammenfassung der Muster und häufigen Fehler. Für einen technischeren Ansatz lohnt sich ein Blick auf die Lernressourcen zur Multi-Agenten-Orchestrierung, die konkrete Implementierungen im Detail beschreiben.
Die ausgereiftesten Implementierungs-Frameworks sind LangGraph (für maximale Flexibilität), CrewAI (für schnelles Prototyping) und AutoGen (für Robustheit). Beginnen Sie mit einem einfachen Prototyp – zwei Agenten, die bei einer einfachen Aufgabe zusammenarbeiten –, um sich mit den Konzepten vertraut zu machen, bevor Sie hochskalieren.
Für spezifische Geschäftsfälle lohnt sich ein Blick auf wie man KI für komplexe Prozesse orchestriert, mit Beispielen echter Automatisierung in verschiedenen Branchen.
Abschließend fasst der umfassende Leitfaden zu Multi-Agenten-Systemen die Architekturen, Muster und Best Practices im Jahr 2026 zusammen – ideal für eine strukturierte Einführung in das Thema.
🔑 Das Wichtigste in Kürze: Multi-Agenten-Architekturen sind kein technisches Spielzeug, sondern eine architektonische Lösung für echte Probleme – die Grenzen einzelner Agenten angesichts geschäftlicher Komplexität. Mit einer rigorosen Orchestrierung, einer strikten Governance und kontinuierlicher Iteration setzen diese Systeme massive betriebliche Vorteile frei: menschliche Produktivität, erhöhte Zuverlässigkeit und vollständige Nachvollziehbarkeit. Fangen Sie klein an, lernen Sie schnell, und skalieren Sie dann hoch.
Author Profile
Latest entries
 Ratgeber20 November 2026Verbraucherkredit: Mini-Kredite, Ratenzahlung und Dispo besser reguliert
 Planet15 November 2026CO2-Emissionen: Warum der Verkehr der Schwachpunkt des Klimaschutzes in Frankreich bleibt
 Künstliche Intelligenz12 November 2026Imagine Enterprise: IBM und Microsoft vereinen ihre KI-Agenten für Großunternehmen
 Wirtschaft11 November 2026Zinssatz des Livret A: Berechnung und Grenzen verstehen
Dieser Artikel wurde mit Unterstützung künstlicher Intelligenz erstellt. Redaktionsrichtlinie