Resumen: Probar y validar un agente autónomo no es cuestión de azar. Es un proceso estructurado que exige comprender los principios del razonamiento de la IA, diseñar escenarios de prueba robustos y establecer una supervisión continua en producción. Este artículo explora las metodologías probadas para evaluar la fiabilidad, el rendimiento y la coherencia de los agentes de IA en entornos reales.
📋 En resumen:
🤖 Un agente autónomo no funciona como un chatbot clásico — debe percibir, razonar y actuar sin intervención directa. Su validación exige un enfoque metódico.
🔍 Los tres pilares de la validación: probar el razonamiento de forma aislada, validar las interacciones con las herramientas y medir la fiabilidad en condiciones reales.
📊 Las métricas importan: tiempo de respuesta, tasa de error, calidad de las decisiones y coherencia del comportamiento a lo largo de varias iteraciones.
⚙️ La orquestación multiagente amplifica los riesgos — la coordinación entre agentes debe probarse tanto como sus comportamientos individuales.
🛠️ Las herramientas esenciales: LangSmith para la trazabilidad, frameworks estructurados para las pruebas y una gobernanza clara de los derechos de acceso.
🎯 La supervisión humana sigue siendo imprescindible — incluso un agente altamente eficaz debe poder detenerse, auditarse y mejorarse de forma continua.
🎯 Comprender el razonamiento de un agente autónomo antes de probarlo
Índice
Probar un agente autónomo sin comprender sus mecanismos internos es un error costoso. A diferencia de un servicio API clásico que recibe una solicitud y devuelve un resultado previsible, un agente funciona según un ciclo iterativo complejo: observa, razona, decide y actúa. Cada etapa comporta posibles puntos de ruptura.
Un agente autónomo se basa en un modelo de lenguaje —a menudo un LLM— que actúa como motor de razonamiento. Este modelo no sigue un guion rígido. Por el contrario, analiza el contexto, evalúa las opciones posibles y selecciona una acción en función de su comprensión del problema. Esta flexibilidad es su fortaleza, pero también su fragilidad: un mismo contexto puede generar respuestas diferentes si el prompt no está suficientemente restringido o si los datos de entrada son ambiguos.
La segunda característica clave es la interacción con herramientas externas. Un agente solo es un sistema de recomendación. Un agente conectado a APIs es un sistema de automatización. Cuando decide llamar a una API, obtiene datos, los procesa y actúa sobre esos resultados, los puntos de ruptura se multiplican: la API puede fallar, los datos pueden ser inválidos o incoherentes con el contexto anterior. El razonamiento del agente debe entonces pivotar y adaptarse.
La tercera dimensión es la memoria y la coherencia contextual. Un agente capaz de conservar el contexto de una tarea anterior y usarlo para refinar sus decisiones futuras es más útil, pero también más difícil de validar. ¿Cómo asegurarse de que no repite un error pasado? ¿Cómo comprobar que su memoria no lo lleva a conclusiones erróneas basadas en información obsoleta?
Antes de construir un plan de pruebas, es necesario responder a estas preguntas fundamentales: ¿cuál es el perímetro decisional del agente? ¿Qué herramientas puede utilizar? ¿Qué grado de autonomía se le otorga? ¿Qué supervisión humana permanecerá activa? Estas respuestas estructuran toda la validación.

🔬 Metodología estructurada para probar el razonamiento y la toma de decisiones
La validación del razonamiento de un agente no se parece a una prueba de software tradicional. No existe una «respuesta correcta» única para una solicitud determinada: más bien existe un espectro de respuestas aceptables según el contexto, las prioridades de negocio y las restricciones operativas. Esta realidad impone una metodología adaptada, basada en la simulación y la observación continua.
📐 Definir un marco de validación coherente
El punto de partida es fijar los criterios de evaluación incluso antes de lanzar las primeras pruebas. Estos criterios deben ser a la vez medibles y relevantes para el negocio. Para un agente de atención al cliente, medir «el tiempo medio de respuesta» tiene poco sentido sin contexto: una respuesta rápida pero incorrecta no ayuda a nadie.
En su lugar, hay que definir criterios multidimensionales. La precisión del razonamiento: ¿extrae el agente correctamente la información relevante de la solicitud del usuario? La coherencia de las decisiones: ante contextos similares, ¿produce el agente respuestas comparables? La fiabilidad operativa: ¿gestiona el agente los casos de error sin crear bucles infinitos o estados inconsistentes?
Estos criterios se expresan en métricas concretas. La evaluación de los agentes de IA según IBM sugiere medir la completitud de las respuestas, la exactitud factual y la relevancia respecto a los objetivos de negocio. Pero también seguir indicadores técnicos: el número de llamadas a las herramientas, la tasa de error en las llamadas externas, la latencia introducida por el razonamiento.
A continuación, hay que establecer umbrales de tolerancia. ¿Puede un agente equivocarse el 5 % de las veces? ¿El 1 %? Depende del uso: un agente que reserva una mesa en un restaurante puede tolerar más errores que un agente que aprueba transacciones financieras. Fijar estos umbrales de antemano evita interpretar los resultados de las pruebas de forma sesgada.
🧪 Diseñar escenarios de prueba representativos
Una vez definido el marco, se trata de crear escenarios de prueba que cubran el espectro de situaciones reales con las que se encontrará el agente. Estos escenarios no deben ser genéricos: deben reflejar patrones observados en producción o anticipados por las áreas de negocio.
La clasificación de los escenarios suele seguir una pirámide: primero los casos nominales (el «happy path»), luego los casos límite y, por último, los casos de fallo o ambigüedad. Por ejemplo, para un agente que procesa pedidos de productos informáticos:
✅ Caso nominal: «Quiero comprar un portátil Dell con 16 GB de RAM» — el agente debe interpretar la solicitud, buscar el producto, confirmar los detalles y preparar el pedido.
⚠️ Casos límite: «Necesito algo potente que no sea demasiado caro» — el agente debe gestionar la ambigüedad, pedir aclaraciones o proponer alternativas.
❌ Casos de error: «Quiero un producto que no vendemos» o «la API de inventario no está disponible» — el agente debe detectar el problema y guiar al usuario hacia una solución.
Para cada escenario se documenta la entrada, el comportamiento esperado y las métricas que hay que observar. Esto constituye una base de pruebas reproducible. Elegir la herramienta agéntica adecuada para ejecutar estas pruebas con regularidad es, además, crucial para mantener la calidad a lo largo del tiempo.
🔄 Establecer bucles de iteración rápidos
El testing de agentes de IA no es un evento puntual. Es un proceso iterativo en el que cada ciclo de observación genera ajustes, ya sea en el prompt, en la lógica de razonamiento o en la configuración de las herramientas.
Un bucle de iteración eficaz funciona según este ciclo: probar el agente en un pequeño corpus de escenarios, analizar los errores, identificar la causa raíz (prompt incorrecto, herramienta defectuosa, límite del modelo), aplicar una corrección y volver a lanzar las pruebas. Este ciclo debe ser rápido —minutos, no horas— para que los desarrolladores y las áreas de negocio puedan iterar sin fricción.
Para acelerar este proceso, instrumentar el agente es indispensable. Cada llamada al modelo, cada interacción con una herramienta, cada decisión tomada debe quedar registrada y ser observable. Cómo plantear estratégicamente el testing de una IA agéntica, según los expertos del sector, implica precisamente capturar estos datos para poder analizarlos a posteriori.
📊 Validar con métricas cuantitativas y cualitativas
Las métricas cuantitativas son fáciles de automatizar: tasa de éxito, latencia media, número de llamadas a herramientas, tasa de error. Pero pueden ocultar problemas cualitativos, como una respuesta técnicamente correcta pero confusa para el usuario.
Por eso hay que combinar lo cuantitativo y lo cualitativo. Un enfoque probado consiste en contar con un panel de validadores humanos que evalúan manualmente una muestra de las respuestas del agente según criterios predefinidos. Esta evaluación humana, aunque consume más tiempo, capta matices que las métricas automatizadas pasan por alto.
Al mismo tiempo, establecer un sistema de alertas sobre las anomalías detectadas permite reaccionar rápidamente si el agente empieza a desviarse. Una tasa de éxito que disminuye progresivamente, una latencia que aumenta o patrones de error recurrentes deben activar una investigación.
⚙️ Orquestación y coordinación: probar las interacciones entre múltiples agentes
Cuando se pasa de un único agente a varios agentes que colaboran, los retos de las pruebas se multiplican. No solo cada agente individual debe funcionar correctamente, sino que el conjunto del sistema también debe mantener su coherencia y su fiabilidad. Aquí es donde realmente se pone a prueba la robustez de una automatización agéntica.
🔗 Probar los flujos de comunicación entre agentes
En un sistema multiagente, cada agente puede desencadenar la ejecución de otro agente, transmitir contexto o esperar una respuesta. Estas interacciones deben probarse tanto de forma aislada como integrada.
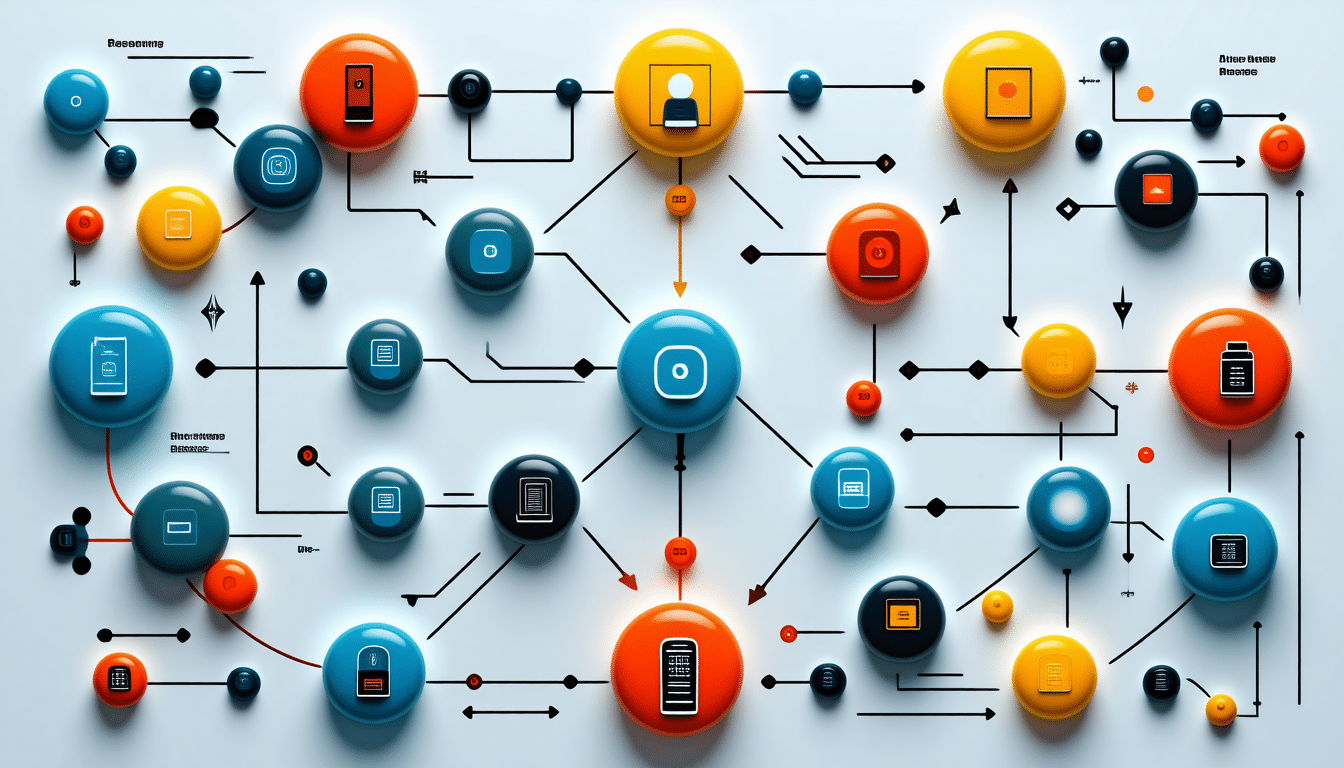
Tomemos un caso concreto: un agente de recopilación obtiene información de varias fuentes, la transmite a un agente de análisis que produce insights, y luego esos insights pasan a un agente de reporting que genera un documento. Cada transición entre agentes es un posible punto de ruptura.
La prueba aislada verifica que el agente de recopilación produce efectivamente los datos esperados, formateados correctamente para el agente de análisis. La prueba de integración garantiza que el flujo completo funciona de extremo a extremo, con los retrasos inherentes y las posibilidades de error en las interfaces.
Las pruebas también deben cubrir los escenarios degradados: ¿qué sucede si el agente de análisis tarda 5 minutos en lugar de 10 segundos en responder? ¿Debe el agente de recopilación esperar o agotar el tiempo de espera? La coordinación entre agentes debe gestionar estos casos de forma explícita; de lo contrario, el sistema entrará en un estado incoherente.
🎯 Validar la lógica de orquestación y las decisiones de enrutamiento
El orquestador decide qué agente ejecutar, en qué orden y con qué parámetros. Es él quien estructura el flujo global. Sus errores pueden anular el buen funcionamiento de los agentes individuales.
Un orquestador mal configurado puede crear bucles infinitos («el agente A llama a B, que llama a A»), distribuir las tareas de forma ineficiente o tomar decisiones de enrutamiento incorrectas. Probar la lógica de orquestación equivale a comprobar que:
✅ Las condiciones de bifurcación son correctas — si el contexto es X, el orquestador debe dirigir realmente hacia el agente adecuado.
✅ No existen bucles infinitos — cada ruta del flujo debe converger hacia un estado terminal.
✅ Los plazos de timeout son realistas — un agente no debe bloquear indefinidamente a los demás.
✅ La escalada funciona — si un agente falla, el orquestador debe poder cambiar a una estrategia de respaldo.
Estas pruebas pueden automatizarse simulando diferentes escenarios y observando las rutas de flujo seguidas. Herramientas como LangGraph facilitan esta visualización y esta validación.
📈 Medir el rendimiento del sistema multiagente en su conjunto
Más allá de las métricas individuales por agente, hay que evaluar el rendimiento global del sistema: tiempo de resolución de extremo a extremo, coste en llamadas API, uso de recursos, calidad del resultado final.
Un sistema que ejecuta cinco agentes de forma secuencial puede resultar muy costoso en latencia. Reestructurarlo para una ejecución parcialmente paralela puede mejorar el tiempo de respuesta, pero crea dependencias más complejas de probar.
La simulación de carga también es fundamental: ¿cómo se comporta el sistema si llegan diez solicitudes simultáneamente? ¿Competirán los agentes por los recursos? ¿Podrá el orquestador mantener la coherencia de los estados? Este tipo de prueba debe realizarse antes de la puesta en producción.
🛡️ Validación en condiciones reales: despliegue piloto y monitorización continua
Un agente muy eficaz en las pruebas de laboratorio puede comportarse de forma diferente en producción. Los datos reales son más ruidosos, las solicitudes de los usuarios más impredecibles y los entornos externos menos previsibles. Por eso se necesita una fase de validación en condiciones reales bien estructurada.
🎪 Estrategia de despliegue progresivo
El paso a producción no debe ser un «big bang». Un enfoque por etapas reduce los riesgos.
🔵 Fase 1 — Despliegue interno: el agente está disponible únicamente para el equipo que lo desarrolla. Es un uso real, no una prueba. Los datos son reales, pero el volumen está controlado. Se observan los errores, los patrones de uso inesperados, y se ajusta.
🟡 Fase 2 — Despliegue piloto limitado: un número reducido de usuarios externos (o de clientes) accede al agente. Se recogen sus comentarios, se miden las métricas clave y se valida que el sistema cumple los SLA definidos.
🟢 Fase 3 — Despliegue general: el agente queda disponible para todos. En esta etapa, la monitorización continua adquiere toda su importancia.
Cada fase debe tener criterios de avance claros: «la tasa de error debe mantenerse por debajo del 2 %» o «la latencia p99 no debe superar los 5 segundos». Si no se alcanzan los criterios, se vuelve a la fase anterior, se corrige y se vuelve a probar.
📊 Establecer una monitorización robusta en producción
Una vez que el agente está en producción, no deja de cambiar. Los datos evolucionan, los comportamientos de los usuarios pueden desviarse, los modelos pueden actualizarse. Una buena monitorización continua detecta estas desviaciones antes de que generen incidentes.
Las métricas que hay que seguir incluyen:
📈 Métricas de rendimiento: latencia, throughput, disponibilidad.
⚠️ Métricas de error: tasa de excepciones, número de llamadas API fallidas, alucinaciones detectadas.
✨ Métricas de negocio: tasa de satisfacción del usuario, tasa de conversión, coste por transacción.
🔍 Métricas de calidad del razonamiento: proporción de decisiones validadas por un humano, distribución de las rutas decisionales, coherencia de las respuestas.
Estas métricas deben visualizarse en tiempo real en paneles accesibles para los equipos de ingeniería y de negocio. Las alertas automáticas deben activar una investigación cuando una métrica se salga de sus rangos aceptables.
🔧 Proceso de corrección y mejora continua
La monitorización genera un flujo constante de señales: «el agente ha fallado en este contexto», «los usuarios se quejan de esta decisión», «acabamos de detectar una nueva clase de errores». Cada señal debe alimentar un bucle de mejora continua.
Un ejemplo concreto: se detecta que el agente de enrutamiento de clientes comete un error en el 3 % de los casos cuando la solicitud menciona una marca de producto en minúsculas (mientras que funciona bien cuando está en mayúsculas). Se identifica la causa (el prompt no insiste lo suficiente en la normalización de los datos), se corrige el prompt, se prueba sobre un corpus de casos históricos y se vuelve a desplegar.
Este bucle debe formalizarse: se necesita un proceso claro para reportar los errores, priorizarlos, investigarlos, corregirlos y probarlos antes de volver a desplegarlos. La guía completa sobre los agentes de IA autónomos propone modelos para estructurar esta gobernanza.
🧠 Técnicas avanzadas: alucinaciones, sesgos y límites del razonamiento
Incluso los mejores agentes de IA tienen debilidades estructurales. El razonamiento del modelo puede generar conclusiones plausibles pero factualmente incorrectas (alucinaciones), reproducir sesgos presentes en los datos de entrenamiento o fallar en problemas lógicos que a un humano le parecen sencillos. Probar y validar también significa identificar y mitigar estos riesgos.
🚨 Detectar y mitigar las alucinaciones
Una alucinación se produce cuando el modelo genera una respuesta que parece sensata pero es factualmente falsa o carece de fundamento. En un contexto profesional, esto es problemático: una referencia de producto inexistente, un precio inventado, un hecho negociado con un cliente pero nunca confirmado.
Varias técnicas permiten reducir el riesgo:
🔗 Grounding sobre datos fiables: en lugar de dejar que el modelo genere una respuesta, se le obliga a usar una herramienta (API) para obtener los datos. Ejemplo: antes de citar un precio, el agente debe llamar a la API de pricing. Si hay una alucinación, se detectará durante la validación de los datos.
✅ Validación posterior a la generación: una vez que el modelo genera una respuesta, se pasa a un validador (a menudo otro modelo o una simple función lógica) que comprueba su coherencia. Si la validación falla, el agente vuelve a intentarlo con un prompt corregido («Atención, su respuesta anterior contenía un error…»).
🔄 Chain-of-thought y explicabilidad: obligar al modelo a «explicar su razonamiento» paso a paso reduce las alucinaciones. En lugar de: «Aquí está la respuesta: X», se le pide: «Así es como he llegado a ello: paso 1… paso 2… conclusión: X». Los errores lógicos se vuelven más visibles.
Pruebas prácticas para validar estas mitigaciones: crear un corpus de escenarios en los que una alucinación sería fácil (por ejemplo, pedir un producto ficticio) y comprobar que el agente resiste correctamente. Medir la tasa de alucinaciones detectadas y la mejora tras cada corrección.
⚖️ Auditar los sesgos en las decisiones del agente
Los modelos de lenguaje heredan los sesgos presentes en sus datos de entrenamiento. Un agente puede discriminar involuntariamente entre grupos de usuarios, tomar decisiones sesgadas según el contexto o reproducir estereotipos. Comprobar la ausencia de sesgos es una obligación legal y ética.
El enfoque clásico consiste en crear escenarios «espejo»: las mismas situaciones, pero con variaciones para comprobar si existe una desigualdad de trato. Por ejemplo, para un agente de selección de candidatos:
📋 Escenario A: candidato con un currículum estándar.
📋 Escenario B: el mismo currículum, pero con un nombre de sonoridad extranjera.
📋 Escenario C: el mismo currículum, pero con un vacío de 2 años en la experiencia.
Si el agente acepta al candidato en A y C, pero lo rechaza en B, es un indicio de un sesgo de discriminación. Estas pruebas deben realizarse regularmente y documentarse.
🧩 Validar los límites del razonamiento en problemas complejos
Existen clases de problemas en los que el razonamiento del modelo alcanza sus límites. Por ejemplo, los modelos LLM actuales tienen dificultades con los cálculos matemáticos complejos o las deducciones lógicas anidadas. Un agente que deba resolver estos problemas debe tener un plan de respaldo: delegar en una herramienta especializada o escalar hacia un humano.
Probar estos límites significa crear casos en los que el razonamiento puro del modelo fallaría, y comprobar que el agente los detecta y los gestiona correctamente. Una validación rigurosa implica saber dónde falla el agente y establecer salvaguardas.
🚀 Integración y despliegue: del test a la producción autónoma
Todas las pruebas han validado al agente, se han alcanzado los criterios, se han gestionado los casos límite. Queda la fase final: el despliegue en producción y el mantenimiento autónomo del sistema. Es ahí donde la teoría se encuentra con la realidad operativa.
🔐 Seguridad, gobernanza y derechos de acceso
Un agente de IA en producción maneja potencialmente datos sensibles. Un agente de RR. HH. accede a archivos personales, un agente financiero a transacciones, un agente comercial a clientes. La seguridad no es opcional.
Cada agente debe tener un perímetro de acceso claramente definido: ¿qué herramientas puede invocar? ¿qué bases de datos puede consultar? ¿con qué permisos? Estos permisos deben ser mínimos: un agente de atención al cliente no necesita acceder a la nómina de los empleados.
Al mismo tiempo, todas las llamadas del agente a las herramientas deben quedar registradas. Si algo ha salido mal, hay que poder reproducir la ejecución completa para entender dónde se rompió la cadena. La arquitectura de los agentes autónomos debe prever esta trazabilidad desde el diseño.
Por último, siempre debe estar disponible un mecanismo de parada de emergencia. Si el agente comienza a producir resultados erróneos o peligrosos, una persona autorizada debe poder detenerlo de inmediato, sin esperar una aprobación o un procedimiento complejo.
📱 Integración con los sistemas de negocio existentes
Son pocas las organizaciones que despliegan agentes en entornos vírgenes. La mayoría debe integrarlos con CRM, ERP y sistemas de tickets ya existentes. Esta integración puede representar el 50 % del trabajo de despliegue.
Las pruebas de integración deben comprobar que:
✔️ El agente puede acceder a las API del sistema objetivo de forma fiable.
✔️ Los formatos de datos se transforman correctamente — los datos enviados por el agente corresponden al esquema esperado por el sistema objetivo.
✔️ Los errores del sistema objetivo se gestionan correctamente — si el CRM responde «este cliente no existe», el agente sabe cómo reaccionar.
✔️ El rendimiento se mantiene aceptable bajo carga — integrar un agente no debe ralentizar el sistema existente.
Estas pruebas deben realizarse en un entorno de staging que reproduzca fielmente la producción, y no en la producción misma.
📈 Escalabilidad y crecimiento
Un agente desplegado puede gestionar con confianza 10 solicitudes al día. Pero ¿qué sucede con 1.000 solicitudes diarias? ¿Con 10.000? Hay que validar que el sistema escala.
Los puntos de fricción incluyen:
💾 Límites de la base de datos: si la memoria a largo plazo del agente se basa en una base de datos vectorial, esta puede volverse lenta si acumula demasiados embeddings.
🌐 Límites de las API externas: las herramientas externas (APIs de terceros, modelos) suelen tener rate limits. El agente debe contar con una estrategia de reintentos y de puesta en cola.
💸 Costes de infraestructura y de modelo: cuanto más se utiliza el agente, más aumentan los costes. Hay que prever un modelo económico viable.
Probar la escalabilidad implica simular una carga futura e identificar los cuellos de botella. A menudo, esto lleva a reestructurar el agente o a añadir capas de caché y de paralelización.
🎯 Establecer una estrategia global de prueba y validación
Todos los elementos anteriores —pruebas de razonamiento, validación multiagente, monitorización en producción— deben formar parte de una estrategia coherente adaptada a su contexto organizativo y tecnológico.
📋 Framework de pruebas adaptado a su madurez
Las organizaciones no abordan el testing de los agentes de IA del mismo modo según su madurez. Un equipo que descubre los agentes autónomos no puede, desde el principio, desplegar un sistema multiagente con una supervisión distribuida. Hay que progresar por etapas.
Nivel 1 — Inicialización: agente único, reglas simples, pruebas esencialmente manuales. Se valida que el agente funciona en los casos nominales. El herramental de pruebas es mínimo, a menudo simples scripts de Python.
Nivel 2 — Estructuración: agente único, pero con una suite de pruebas automatizadas, monitorización básica y una documentación clara de los casos de uso. Se crea una repetibilidad de la prueba.
Nivel 3 — Sofisticación: múltiples agentes, pruebas parametrizadas que cubren casos límite y escenarios de error, orquestación validada. Se despliega un framework de pruebas estructurado.
Nivel 4 — Continuidad: mejora continua en producción, feedback loops automatizados, autorremediación en ciertas clases de errores. El testing se convierte en una actividad permanente.
La formación para crear, probar y desplegar agentes de IA propone itinerarios estructurados para progresar según esta madurez.
🛠️ Seleccionar las herramientas y frameworks adecuados
El ecosistema de herramientas para probar agentes de IA se enriquece rápidamente. LangSmith se impone como referencia para la trazabilidad y el debugging. LangGraph ofrece una excelente estructura para orquestar los agentes. CrewAI proporciona un framework completo para los sistemas multiagente.
La elección depende de su stack técnico existente y de sus necesidades específicas. Pero hay una recomendación universal: no ignorar la trazabilidad. Una herramienta que le permita visualizar exactamente lo que ha hecho un agente —qué prompt se envió, qué API se llamó, qué resultado se recibió— es indispensable.
👥 Roles y responsabilidades en el testing
El testing de agentes de IA no es solo un trabajo de ingeniería. Es una colaboración:
🔧 Ingenieros de IA: diseño de los agentes, implementación de la lógica, debugging.
🧪 QA especializado en IA: diseño de los escenarios de prueba, validación de los resultados, identificación de sesgos.
👔 Negocio: validación de que los resultados corresponden a las expectativas del negocio, reporte de casos reales no cubiertos por la prueba.
📊 DataOps / SRE: monitorización en producción, escalada de incidentes, optimización del rendimiento.
Cada rol aporta una perspectiva única. Los ingenieros por sí solos no verán los sesgos de negocio, y las áreas de negocio no verán las fallas técnicas. Estructurar una colaboración entre estos roles es clave para una validación robusta.
📅 Planificación de un programa de pruebas continuo
La prueba no es una fase final que se termina. Es un programa permanente. Una buena práctica consiste en planificar:
⏰ Pruebas unitarias diarias: validación de que los componentes individuales del agente siguen funcionando.
⏰ Pruebas de integración semanales: verificación de que el flujo completo multiagente funciona.
⏰ Pruebas de evolución mensuales: simulación de nuevas versiones de modelos, cambios de API o nuevos requisitos de negocio.
⏰ Auditorías de gobernanza trimestrales: control de los derechos de acceso, revisión de los registros de ejecución, verificación del cumplimiento.
Esta planificación impone una disciplina, pero garantiza que el agente siga siendo fiable y operativo.
📚 Para profundizar en su comprensión de los agentes autónomos y de su razonamiento complejo, explore el framework de razonamiento agéntico con los LLM y descubra cómo diseñar sistemas de prueba adaptados a sus necesidades.
Author Profile
Latest entries
 Planeta15 November 2026Emisiones de CO2: por qué el transporte sigue siendo el punto negro del clima en Francia
 Inteligencia Artificial12 November 2026Imagine Enterprise: IBM y Microsoft unen sus agentes de IA para las grandes empresas
 Economía11 November 2026Tipo del Livret A: cómo se calcula y cuáles son sus límites
 Compras8 November 2026Black Friday: las fechas clave y el presupuesto previsto por los franceses
Este artículo ha sido redactado con la ayuda de una inteligencia artificial. Política editorial